Fundamentos
Complejidad de algoritmos (Big-O) explicada con Python
Aprende qué es la notación Big-O, cuenta pasos en Python y compara O(1), O(log n), O(n) y O(n²) con ejemplos que corren en el simulador, sin cronómetro.
Por Prof. Rodrigo Faustino · Actualizado el · 21 min de lectura
Métricas de este artículo
- Palabras
- 4099
- Caracteres
- 22.497
- Tiempo de lectura
- ~21 min
En los artículos anteriores, dos preguntas quedaron en el aire. ¿Por qué la búsqueda binaria es mucho más rápida que la búsqueda lineal? ¿Por qué el merge sort aguanta listas grandes y el bubble sort no? En cada caso, hubo un conteo de comparaciones y una frase del tipo "el trabajo crece con el cuadrado de n". Este artículo le da un nombre y un método a esa idea: la complejidad de algoritmos, escrita con la notación Big-O.
La pregunta que responde es simple: cuando la entrada crece, ¿cuánto crece el trabajo? Un programa que tarda un instante con 10 lecturas puede tardar una eternidad con 10 mil, o puede seguir siendo instantáneo. Saber cuál de los dos casos vale antes de correrlo es una de las habilidades más útiles de quien programa, y en la ESP32 pesa más que en el computador, porque la placa tiene mucha menos memoria y velocidad. Todos los ejemplos de abajo corrieron en el simulador, y los números citados son los que él produce. Lo que el Python del computador muestra de diferente está dicho en el texto.
Contar pasos en lugar de segundos
La primera idea que se le ocurre a cualquiera es cronometrar: correr el programa y medir cuánto tiempo tardó. El problema es que el tiempo depende de todo lo que está alrededor. La misma función tarda una cosa en el computador, otra en la placa, otra si el computador está ocupado, y otra más si el simulador está corriendo en una pestaña llena. Un número en segundos no dice nada sobre el algoritmo, solo sobre esa ejecución.
La salida es contar pasos. Se elige la operación que mejor representa el trabajo, como una comparación o una vuelta de bucle, y se cuenta cuántas veces ocurre en función del tamaño n de la entrada. El conteo es el mismo en cualquier máquina. Mira cuatro funciones con costos muy diferentes, cada una devolviendo cuántos pasos dio:
def constante(lista):
    return lista[0], 1

def linear(lista):
    passos = 0
    total = 0
    for v in lista:
        total += v
        passos += 1
    return total, passos

def quadratico(lista):
    passos = 0
    for i in range(len(lista)):
        for j in range(len(lista)):
            passos += 1
    return passos

def logaritmico(n):
    passos = 0
    while n > 1:
        n = n // 2
        passos += 1
    return passos

for n in [10, 20, 40, 80]:
    lista = list(range(n))
    print(n, "O(1):", constante(lista)[1], "O(n):", linear(lista)[1], "O(n^2):", quadratico(lista), "O(log n):", logaritmico(n))
print(logaritmico(1000), logaritmico(1000000), logaritmico(1))
print("fin")La salida tiene cuatro líneas, una por tamaño, y después 9 19 0 y fin. Para n = 10, la primera línea muestra O(1): 1, O(n): 10, O(n^2): 100 y O(log n): 3. Para n = 80, vienen 1, 80, 6400 y 6. Compara las columnas a medida que n se duplica de 10 a 20, a 40 y a 80. La de O(1) queda quieta en 1. La de O(log n) sube de 3 a 4, 5 y 6, solo un paso en cada duplicación. La de O(n) se duplica junto, y la de O(n^2) se cuadruplica: 100, 400, 1600, 6400.
Eso es lo que el Big-O describe. No interesa si un paso tarda un microsegundo o un milisegundo. Interesa la forma de la curva que el trabajo dibuja a medida que n crece.

Del programa al semestre planificado
- Plan de enseñanza y calendario montados solos
- Diario de clases listo para pegar en el SIGA
- Diapositivas y listas de ejercicios con solucionario
Versión Community gratis · Windows
Medir el tiempo también tiene su lugar
Contar pasos no sustituye al cronómetro, solo responde otra pregunta. Cuando la duda es "¿este trozo cabe en el tiempo que tengo entre dos lecturas del sensor?", la respuesta viene de medir en la propia placa. MicroPython ofrece time.ticks_ms() y time.ticks_us() para eso, y time.ticks_diff() para restar dos instantes de forma segura, ya que el contador da la vuelta después de cierto tiempo:
import time
print(hasattr(time, "ticks_ms"), hasattr(time, "ticks_us"), hasattr(time, "ticks_diff"))
t0 = time.ticks_ms()
t1 = time.ticks_ms()
d = time.ticks_diff(t1, t0)
print(type(d), d >= 0)
print("fin")La salida es True True True, después <class 'int'> True y fin. Estas funciones son de MicroPython. En el Python del computador no existen, y allí se usa time.perf_counter(). Los valores medidos no aparecen en los ejemplos de este artículo porque cambian en cada ejecución, y una salida que cambia no sirve para comprobar lo que se aprendió. La regla práctica es usar el conteo para elegir el algoritmo y el cronómetro para decidir si sirve en la placa.
Qué describe el Big-O
Escribir O(n) se lee "orden de n", y dice que el trabajo crece proporcionalmente a n. Dos reglas transforman un conteo exacto en una clase:
- Solo cuenta el término que más crece. Si un algoritmo hace
3n² + 5n + 2pasos, esO(n²), porque parangrande los otros términos desaparecen frente al primero. - Las constantes multiplicativas no cuentan.
3n²yn²son de la misma clase, porque triplicar el tiempo no cambia la forma de la curva.
La tabla de abajo muestra por qué funciona la primera regla. Calcula 3n² + 5n + 2 y la parte que le toca al término 3n²:
for n in [10, 100, 1000, 10000]:
    total = 3 * n * n + 5 * n + 2
    so_n2 = 3 * n * n
    print(n, total, so_n2, round(100 * so_n2 / total, 2))
print("fin")La salida es 10 352 300 85.23, 100 30502 30000 98.35, 1000 3005002 3000000 99.83, 10000 300050002 300000000 99.98 y fin. Con 10 elementos, el término 3n² responde por el 85% del total. Con 10 mil, por casi el 100%. Los términos 5n y 2 se vuelven un detalle, y por eso el Big-O los descarta.
Esto también muestra el límite de la notación. O(n²) no dice que un algoritmo es lento, dice que se vuelve lento cuando n crece. Con pocos elementos, un O(n²) simple puede ganarle a un O(n log n) complicado. La notación habla del futuro del algoritmo, no del presente.
Las clases más comunes
Casi todo lo que se escribe cae en una de estas clases, de la más barata a la más cara:
O(1), constante. El trabajo no depende de n. Leer lista[0], leer lista[i], tomar len(lista), sumar dos números, buscar una clave en un diccionario. En general, también lista.append(x).
O(log n), logarítmica. El trabajo crece de a poco, un paso cada vez que el tamaño se duplica. Es el caso de quien corta el problema por la mitad en cada paso, como la búsqueda binaria.
O(n), lineal. Un bucle que pasa por cada elemento una vez. Sumar la lista, hallar el mayor, la búsqueda lineal, x in lista, sum(lista), max(lista).
O(n log n). El costo típico de las buenas ordenaciones, como el merge sort. Un poco por encima de lineal.
O(n²), cuadrática. Un bucle dentro de otro, ambos recorriendo la lista. Bubble, selection e insertion sort, comparar todos los pares.
O(2ⁿ) y semejantes, exponencial. El trabajo se duplica, o más, con cada elemento de más. Solo sirve para entradas minúsculas. El Fibonacci recursivo, más adelante, es un ejemplo.
Una manera de reconocer la clase mirando el código es contar los bucles anidados: sin bucle sobre la entrada el costo suele ser O(1) o O(log n), un bucle sobre n es O(n), dos anidados son O(n²). Pero atención a tres cuidados que el conteo de bucles no capta.
def dois_lacos_seguidos(n):
    passos = 0
    for i in range(n):
        passos += 1
    for j in range(n):
        passos += 1
    return passos

def laco_triangular(n):
    passos = 0
    for i in range(n):
        for j in range(i):
            passos += 1
    return passos

def meio_com_barra(n):
    passos = 0
    while n > 1:
        n = n / 2
        passos += 1
    return passos

def meio_com_duas_barras(n):
    passos = 0
    while n > 1:
        n = n // 2
        passos += 1
    return passos

for n in [10, 20, 40]:
    print(n, dois_lacos_seguidos(n), laco_triangular(n))
print(meio_com_barra(1000), meio_com_duas_barras(1000))
print("fin")La salida empieza con 10 20 45, 20 40 190 y 40 80 780, y después 10 9 y fin. Los dos bucles seguidos hacen 2n pasos, que sigue siendo O(n): el dos desaparece por la segunda regla. Los bucles anidados del triángulo, en que el de adentro va solo hasta i, hacen n(n-1)/2 pasos. Es la mitad del cuadrado, y aun así es O(n²): de 20 a 40 elementos, el trabajo va de 190 a 780, cerca de cuatro veces. Y la última línea muestra una trampa silenciosa: con /, el n se vuelve decimal y el bucle solo termina cuando el valor cae por debajo de 1, lo que da 10 pasos. Con //, la división entera se detiene en 1 y da 9. La clase es la misma, pero el conteo exacto cambia, y el programa no avisa.
La IA que recuerda tu vida y vive en tu ordenador
- Memoria a largo plazo con la fuente de cada respuesta
- Funciona sin conexión: tus datos se quedan en tu PC
- Lee PDF, diapositivas, fotos y grabaciones de reuniones
Plan Esencial gratis para siempre
O(log n): cortar el problema por la mitad
El logaritmico del primer ejemplo merece una mirada de cerca, porque la clase es la que menos se ve en lo cotidiano. Pregunta: ¿cuántas veces puedo dividir n por la mitad hasta llegar a 1? Para 1000, la respuesta fue 9. Para un millón, 19. Para 1, ninguna, 0.
Fíjate en el tamaño del salto: de mil a un millón, mil veces más elementos, el trabajo fue de 9 a 19 pasos. Ese es el poder de la búsqueda binaria. Buscar en un millón de elementos ordenados exige cerca de 20 comparaciones. La búsqueda lineal, en el peor caso, exigiría un millón. Es la razón de que la ordenación, con su costo de O(n log n), compense cuando se va a buscar muchas veces en la lista: se paga una vez, y cada búsqueda después cuesta casi nada.
El logaritmo aparece siempre que un paso descarta una fracción de lo que queda, y no una cantidad fija. La base del logaritmo, 2, 10 u otra, no importa para el Big-O, porque cambiar de base solo multiplica por una constante. En los ejemplos, se usa la división por 2 porque es la que hacen los algoritmos.
Cuando la recursión explota: el Fibonacci
La recursión puede esconder un costo enorme bajo un código corto y bonito. El ejemplo clásico es el Fibonacci, en que cada número es la suma de los dos anteriores. La versión recursiva copia la definición casi palabra por palabra, y la versión en bucle guarda solo los dos últimos valores. Las dos dan el mismo resultado, y el programa cuenta el trabajo de cada una:
chamadas = 0
def fib(n):
    global chamadas
    chamadas += 1
    if n < 2:
        return n
    return fib(n - 1) + fib(n - 2)

def fib_laco(n):
    a = 0
    b = 1
    passos = 0
    for i in range(n):
        a, b = b, a + b
        passos += 1
    return a, passos

for n in [5, 10, 15, 20]:
    chamadas = 0
    r = fib(n)
    print(n, r, "llamadas:", chamadas, "| bucle:", fib_laco(n))
print("fin")La salida tiene cuatro líneas y el fin. Para n = 5, 5 5 llamadas: 15 | bucle: (5, 5). Para n = 10, 10 55 llamadas: 177 | bucle: (55, 10). Para 15, 15 610 llamadas: 1973 | bucle: (610, 15). Para 20, 20 6765 llamadas: 21891 | bucle: (6765, 20).
El resultado es el mismo en las dos versiones, pero el trabajo no. El bucle da n pasos. La recursión da 15, 177, 1973 y 21891 llamadas, y la razón entre una línea y la siguiente queda en torno a 11: cada 5 unidades más en n multiplican el trabajo por cerca de once. Eso es crecimiento exponencial. La causa es que fib(n) llama a fib(n - 1) y fib(n - 2), y los dos recalculan, cada uno por su cuenta, casi todo lo que el otro ya calculó. Para fib(30), serían más de 2,6 millones de llamadas, y para fib(40), más de 331 millones. Esos dos totales salen de la cuenta de la fórmula, no de una ejecución, porque el simulador no es lugar para correr tanto trabajo.
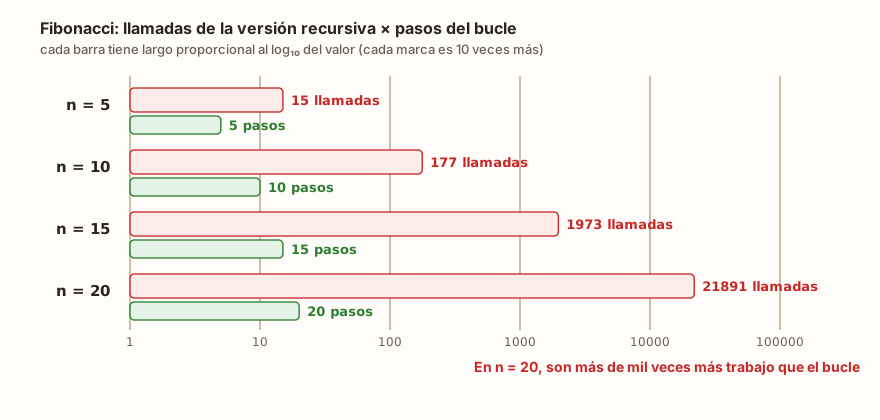
La lección no es "evita la recursión". El merge sort es recursivo y es O(n log n). La lección es que la forma del código no dice el costo: hay que contar cuántas veces corre cada trozo. En el Fibonacci, el desperdicio viene de recalcular los mismos valores, y la cura es guardar lo que ya se calculó, sea en un bucle, sea en un diccionario usado como memoria.
El mismo problema con tres costos
Mira cómo la elección del algoritmo cambia la clase de un mismo problema: descubrir si una lista tiene valores repetidos. Tres maneras, cada una contando sus pasos:
def duplicados_quadratico(lista):
    comparacoes = 0
    for i in range(len(lista)):
        for j in range(i + 1, len(lista)):
            comparacoes += 1
            if lista[i] == lista[j]:
                return True, comparacoes
    return False, comparacoes

def duplicados_ordenando(lista):
    copia = sorted(lista)
    comparacoes = 0
    for i in range(1, len(copia)):
        comparacoes += 1
        if copia[i] == copia[i - 1]:
            return True, comparacoes
    return False, comparacoes

def duplicados_conjunto(lista):
    vistos = set()
    passos = 0
    for v in lista:
        passos += 1
        if v in vistos:
            return True, passos
        vistos.add(v)
    return False, passos

for n in [10, 100]:
    sem = list(range(n))
    print(n, "sin repetidos:", duplicados_quadratico(sem), duplicados_ordenando(sem), duplicados_conjunto(sem))
com = [3, 8, 1, 9, 4, 8, 2]
print(duplicados_quadratico(com), duplicados_ordenando(com), duplicados_conjunto(com))
print("fin")La salida tiene tres líneas y el fin. La primera, para 10 elementos sin repetición, es 10 sin repetidos: (False, 45) (False, 9) (False, 10). La segunda, para 100, es 100 sin repetidos: (False, 4950) (False, 99) (False, 100). La tercera, con repetido, es (True, 10) (True, 5) (True, 6).
Los tres responden bien, pero con costos diferentes. El primero compara todos los pares: 45 comparaciones con 10 elementos y 4950 con 100. Es O(n²), como el bucle triangular del ejemplo anterior. El segundo ordena primero, y después los repetidos quedan lado a lado, de modo que basta comparar cada elemento con el anterior, 9 y 99 comparaciones. Pero esos conteos no incluyen la ordenación, que cuesta O(n log n). El costo total del método es el de la ordenación, porque domina al de las comparaciones. El tercero usa un conjunto: para cada valor, pregunta si ya fue visto, y la pregunta v in vistos cuesta O(1) en promedio. Son 10 y 100 pasos, O(n).
El tercero parece el ganador, y en la mayoría de los casos lo es, pero trae un costo que el conteo de pasos no muestra: el conjunto guarda una copia de los valores, y eso gasta memoria. En la ESP32, con poca memoria, cambiar tiempo por espacio no siempre es un buen negocio. El primer método casi no gasta memoria además de la lista. Esto es común: rara vez existe un algoritmo que gane en todo, y elegir es equilibrar tiempo, memoria y simplicidad.
Fíjate también en el caso de la lista com, con el 8 repetido: los métodos se detuvieron temprano, después de 10, 5 y 6 pasos. Ese es el mejor caso, cuando la respuesta aparece antes del final. El Big-O suele hablar del peor caso, que es el de la lista sin repetidos, porque es él quien garantiza un límite de espera. Es lo que se mide en la tabla de conteos con 10 y 100 elementos.
El costo escondido dentro de un comando
El conteo de bucles engaña cuando un comando de una línea esconde un bucle. El ejemplo más común es el in aplicado a una lista: x in lista parece una pregunta, pero por debajo es una búsqueda lineal, O(n). Dentro de un bucle, se vuelve O(n²) sin que el código muestre dos bucles:
def contem(lista, x):
    global comparacoes
    for v in lista:
        comparacoes += 1
        if v == x:
            return True
    return False
comparacoes = 0
def sem_repetidos_lista(dados):
    global comparacoes
    resultado = []
    for x in dados:
        if not contem(resultado, x):
            resultado.append(x)
    return resultado
for n in [10, 100]:
    comparacoes = 0
    r = sem_repetidos_lista(list(range(n)))
    print(n, len(r), comparacoes)
dados = [3, 1, 3, 2, 1]
comparacoes = 0
print(sem_repetidos_lista(dados), comparacoes, sorted(set(dados)))
print("fin")La salida es 10 10 45, 100 100 4950, [3, 1, 2] 6 [1, 2, 3] y fin. La función contem hace el papel del in y cuenta las comparaciones, para que el trabajo escondido quede a la vista. Con 10 elementos sin repetición, fueron 45 comparaciones, y con 100, 4950: los mismos números del método cuadrático de la sección anterior, solo que ahora dentro de una función que, a primera vista, tiene un solo bucle. La última línea muestra que la función mantiene el orden de la primera aparición ([3, 1, 2]), mientras que sorted(set(dados)) devuelve los valores ordenados.
Otros comandos que esconden un bucle son sum, max, min, lista.index(x), lista.count(x), lista.remove(x) y el rebanado lista[a:b], que copia los elementos. Todos cuestan O(n), y dentro de un bucle sobre la misma lista pesan como un segundo bucle. En cambio, el in de un conjunto o de un diccionario cuesta O(1) en promedio, y por eso el tercer método de la sección anterior quedó lineal.
El ejemplo siguiente junta todo en una situación real de la ESP32: el promedio móvil de las últimas lecturas de un sensor. La versión ingenua rehace la suma de la ventana entera en cada lectura. La astuta mantiene la suma y solo actualiza las puntas: suma el valor nuevo y quita el que salió de la ventana.
leituras = [20, 22, 21, 25, 30, 28, 27, 26, 24, 23]
janela = 4

def media_movel_refazendo(dados, k):
    medias = []
    somas = 0
    for i in range(k - 1, len(dados)):
        s = 0
        for j in range(i - k + 1, i + 1):
            s += dados[j]
            somas += 1
        medias.append(s / k)
    return medias, somas

def media_movel_acumulando(dados, k):
    medias = []
    operacoes = 0
    s = 0
    for i in range(len(dados)):
        s += dados[i]
        operacoes += 1
        if i >= k:
            s -= dados[i - k]
            operacoes += 1
        if i >= k - 1:
            medias.append(s / k)
    return medias, operacoes

m1, c1 = media_movel_refazendo(leituras, janela)
m2, c2 = media_movel_acumulando(leituras, janela)
print(m1)
print(m2)
print(m1 == m2, c1, c2)
grandes = list(range(100))
print(media_movel_refazendo(grandes, 10)[1], media_movel_acumulando(grandes, 10)[1])
print(media_movel_refazendo(grandes, 50)[1], media_movel_acumulando(grandes, 50)[1])
print("fin")La salida empieza con las dos listas de promedios, iguales: [22.0, 24.5, 26.0, 27.5, 27.75, 26.25, 25.0]. Después viene True 28 16, las sumas hechas por los dos métodos en las 10 lecturas. Después 910 190, para 100 lecturas y ventana de 10, y 2550 150, para ventana de 50, y el fin.
Las dos versiones dan la misma respuesta, y esa es la gracia: el mismo problema, el mismo resultado, y costos muy diferentes. La versión que rehace la suma hace (n - k + 1) * k sumas, que crece con el tamaño de la ventana: 910 con ventana 10 y 2550 con ventana 50. La que acumula hace cerca de 2n operaciones, casi siempre las mismas, 190 y 150, porque la ventana mayor no pesa. La primera es O(n * k), y la segunda es O(n). En una placa que lee un sensor varias veces por segundo, la diferencia decide si el programa da abasto.
Los algoritmos de esta parte
Con la notación a mano, los algoritmos de los artículos anteriores se resumen en una tabla. Las columnas separan el mejor y el peor caso, porque varios algoritmos se comportan de manera distinta según la entrada:
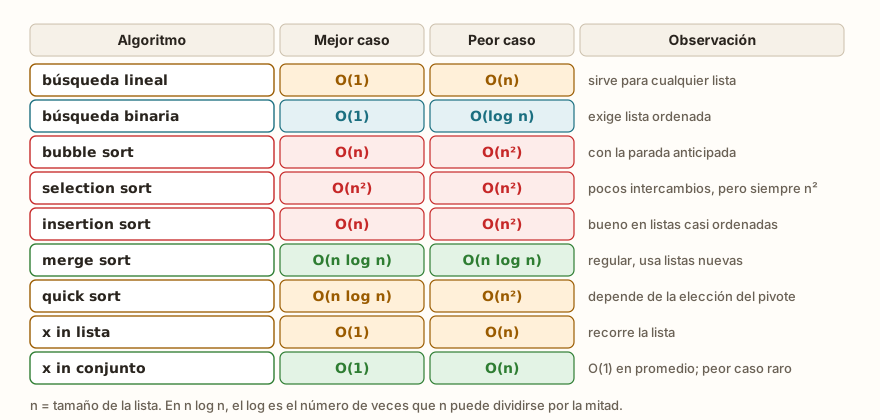
Algunos puntos para leer la tabla con cuidado:
- La búsqueda lineal acierta de primera si el valor está al comienzo,
O(1), y recorre todo si está al final o no existe,O(n). - La búsqueda binaria es
O(log n), pero solo funciona en una lista ordenada. Ordenar cuestaO(n log n), así que solo compensa cuando se busca varias veces. - El bubble sort con parada anticipada hace
O(n)en una lista ya ordenada, una sola pasada. El selection sort no tiene esa salida: hace las mismas comparaciones en cualquier lista, y lo que ahorra son los intercambios. - El insertion sort también es
O(n)cuando la lista ya está casi en orden. Por eso el artículo sobre él lo recomienda para listas pequeñas y casi ordenadas. - El merge sort mantiene
O(n log n)en cualquier entrada, pero crea listas nuevas. En el artículo anterior, una lista invertida de 1000 elementos pidió 5044 comparaciones en el merge sort, contra 499500 del insertion sort, este segundo valor calculado por la fórmula. - El quick sort es
O(n log n)en promedio, pero cae aO(n²)en el peor caso, cuando el pivote elegido es siempre el menor o el mayor elemento.
La tabla también recuerda una verdad incómoda: para listas pequeñas, todo es rápido. La diferencia entre las clases solo aparece cuando n crece. Si tu lista tiene 20 elementos y nunca va a pasar de eso, el algoritmo más simple de entender es, muchas veces, el mejor.
Lo que el Big-O no dice
La notación es una herramienta, no un veredicto, y vale la pena conocer sus límites:
- No mide el tiempo real. Dos algoritmos
O(n)pueden diferir en diez veces, porque el Big-O descarta las constantes. El cronómetro en la propia placa es el que da la respuesta final. - No mide la memoria. El método del conjunto ganó en tiempo y perdió en espacio. Existe una complejidad de espacio, escrita con la misma notación, y en la ESP32 importa tanto como la de tiempo.
- No vale para
npequeño. Las constantes y los términos menores, que la notación ignora, deciden cuandones pequeño. - Depende de la entrada. Por eso existen el mejor, el medio y el peor caso, y hay que saber de cuál se está hablando.
- Depende de lo que se cuenta. Contar comparaciones, intercambios o llamadas da números diferentes, y todos son válidos siempre que se diga cuál fue la elección.
En la ESP32: dónde esto pesa
En un programa de sensores, el n casi nunca es grande, pero el bucle principal corre para siempre. Una función O(n²) sobre 50 lecturas hace 2500 pasos, y si corre en cada ciclo, el programa se pasa todo el tiempo en ella. Tres situaciones en que la cuenta compensa:
- Promedio o filtro de las últimas lecturas. Como en el promedio móvil de arriba, rehacer la suma en cada lectura cuesta
O(n * k). Mantener la suma cuestaO(n). - Buscar en una tabla de calibración. Si la tabla se consulta todo el tiempo, guardarla ordenada y usar la búsqueda binaria, o en un diccionario, cuesta mucho menos que recorrerla en cada consulta.
- Guardar un historial. Una lista que solo crece acaba con la memoria de la placa. Limitar el tamaño, descartando lo más antiguo, es una decisión de espacio que el Big-O de tiempo no ve.
En todos estos casos, el camino es el mismo del artículo: contar los pasos, mirar cómo crece la cuenta, y solo después, si la duda persiste, medir en la placa con time.ticks_ms().
Errores comunes
Confundir dos bucles con O(n²). Dos bucles seguidos suman, O(n + n), y siguen siendo O(n). Solo los anidados multiplican. Antes de escribir O(n²), comprueba si un bucle está realmente dentro del otro y si los dos recorren el tamaño de la entrada.
Olvidar el bucle escondido. x in lista, max, sum y el rebanado son bucles. Contar solo los for y while que aparecen en el código da una clase menor que la verdadera.
Dejar de contar la ordenación. Cuando un método empieza con sorted(lista), su costo es al menos el de la ordenación, y no el del bucle que viene después. En el computador, el sorted() es O(n log n).
Confundir mejor caso con caso común. Un algoritmo que se detuvo temprano en la lista de prueba puede necesitar la lista entera en otra. Prueba siempre el peor caso, como la lista sin repetidos o el valor que no existe.
Medir solo con n pequeño. Con 10 elementos, O(n²) y O(n) parecen iguales. Compara conteos con n, 2n y 4n, como en los ejemplos, y mira qué pasa cuando se duplica.
Contar sin decir qué. Un conteo de "pasos" que mezcla comparaciones y asignaciones no tiene significado. Elige una operación y cuenta solo esa.
Lo que suele aparecer en el aula
Son patrones que se repiten en quien aprende este tema. No son el relato de un grupo específico.
Creer que Big-O es una medida de segundos. La persona pregunta "¿cuántos segundos es O(n)?". La notación no responde eso, solo dice cómo crece el trabajo. El conteo de pasos, antes del cronómetro, ayuda a separar las dos ideas.
Memorizar la tabla sin saber contar. Quien memoriza "la búsqueda binaria es log n" pero no logra contar los pasos de un bucle pequeño se traba en la primera función diferente. Contar a mano, para n = 4 y n = 8, y comprobar en el simulador enseña más que la tabla.
Creer que menos líneas es más rápido. Una línea con x in lista dentro de un bucle parece más ligera que dos bucles, y cuesta lo mismo. El tamaño del código no dice nada sobre el costo.
Ignorar el bucle dentro del comando. La pregunta que ayuda es: ¿qué hace este comando por debajo? Si la respuesta es "recorre la lista", es un bucle.
Querer la clase más baja en todo. Reescribir un programa de 20 elementos para ganar una clase solo complica el código. La pregunta correcta es si el n va a crecer.
Ejercicio: contar pasos con la entrada del usuario
Escribe un programa que lea un tamaño n, cuente los pasos de un bucle simple y de dos bucles anidados, y muestre los dos totales. Enseguida, pide otro n y repite solo los dos bucles, para ver el efecto de duplicar. Usa entradas de 6 y 12 en el simulador, que es lo que hace el bloque de abajo:
n = int(input("¿Cuántos elementos? "))
passos_um = 0
for i in range(n):
    passos_um += 1
passos_dois = 0
for i in range(n):
    for j in range(n):
        passos_dois += 1
print("n =", n)
print("un bucle:", passos_um)
print("dos bucles:", passos_dois)
n = int(input("¿Y ahora? "))
passos_dois = 0
for i in range(n):
    for j in range(n):
        passos_dois += 1
print("n =", n, "dos bucles:", passos_dois)
print("fin")El simulador muestra cada pregunta seguida del valor escrito, de modo que la salida empieza con ¿Cuántos elementos? 6. Después vienen n = 6, un bucle: 6, dos bucles: 36, ¿Y ahora? 12, n = 12 dos bucles: 144 y fin. Fíjate: el n se duplicó de 6 a 12, y los pasos del bucle doble fueron de 36 a 144, cuatro veces más, como la tabla del comienzo preveía.
Para practicar, prueba: cambiar el bucle doble por uno triangular y comprobar la fórmula n(n-1)/2; agregar un tercer bucle anidado y ver la clase pasar a O(n³); contar los pasos de un while que divide n por 2; y escribir una función que cuente las comparaciones de la búsqueda lineal en el peor caso.
Preguntas frecuentes
¿Qué significa la O en Big-O? Es la letra de "orden": el orden de magnitud del crecimiento del trabajo. O(n²) se lee "O de n al cuadrado".
¿Cuál es la diferencia entre O(n) y O(n log n)? El segundo crece un poco más rápido. Para un millón de elementos, n log n es cerca de 20 millones, contra un millón de n. Para listas pequeñas, casi no se nota.
¿O(1) quiere decir un solo paso? Quiere decir que el número de pasos no depende de n. Puede ser uno, dos o diez, siempre que no crezca junto con la entrada.
¿Importa la base del logaritmo? Para el Big-O, no. Cambiar de base multiplica por una constante, y las constantes no cuentan.
¿Por qué el Big-O habla del peor caso? Porque da una garantía: el algoritmo nunca va a tardar más que eso. El mejor caso es demasiado optimista para planificar el tiempo de un programa.
¿Existe Big-O para la memoria? Existe, y se llama complejidad de espacio. El método del conjunto, por ejemplo, gasta O(n) de espacio de más para ganar tiempo.
¿El sorted() de MicroPython tiene el mismo costo que el del Python del computador? En el computador, el sorted() es O(n log n). La implementación de MicroPython es otra, como ya apareció en la estabilidad, y este artículo no afirma su costo exacto.
¿Necesito saber Big-O para programar la ESP32? Para los primeros proyectos, no. Pero evita el susto de un programa que funciona bien con 10 lecturas y se traba con 1000.
Para continuar
Los desafíos Búsqueda en la lista, Mayor de la lista y Media de la lista son buenos para contar pasos: resuelve cada uno y di cuál es la clase de tu solución. Para repasar la base, pasa por los artículos sobre búsqueda lineal y binaria, bubble y selection sort, insertion sort, merge sort y quick sort, recursividad y conjuntos, y por la ruta de lógica.
El próximo artículo abre una nueva parte de la serie, sobre objetos, errores y buenas prácticas, con las clases y los objetos: cómo juntar datos y funciones en una sola cosa, con atributos, métodos y el __init__, y cómo eso organiza un programa que crece.