Fundamentos
Merge sort y quick sort en Python: dividir para conquistar
Entiende cómo el merge sort y el quick sort ordenan dividiendo la lista, escríbelos con recursión, compara el costo y conoce el límite de recursión.
Por Prof. Rodrigo Faustino · Actualizado el · 17 min de lectura
Métricas de este artículo
- Palabras
- 3282
- Caracteres
- 18.096
- Tiempo de lectura
- ~17 min
Los algoritmos del artículo anterior, bubble, selection e insertion, tienen en común un límite: el trabajo crece con el cuadrado del tamaño de la lista. Para 100 elementos, son unas 5 mil comparaciones. Para mil, casi medio millón. Existe una idea más astuta para listas mayores, que vale en toda la computación: dividir para conquistar. En lugar de atacar la lista entera, se divide el problema en partes menores, se resuelve cada parte de la misma manera, y se junta el resultado.
Dos algoritmos clásicos de ordenación siguen esa idea, y los dos usan recursión. El merge sort divide la lista por la mitad sin pensar, ordena las dos mitades y después las mezcla. El quick sort elige un elemento, el pivote, separa los menores de un lado y los mayores del otro, y ordena cada lado. El primero hace el trabajo a la hora de juntar, y el segundo, a la hora de dividir. Este artículo escribe los dos, mide el costo y muestra un límite del simulador, que imita el de la placa, que pesa más en estos algoritmos que en los anteriores. Todos los ejemplos corrieron en el simulador, y los resultados citados son los que él produce.
Merge sort: dividir por la mitad, juntar en orden
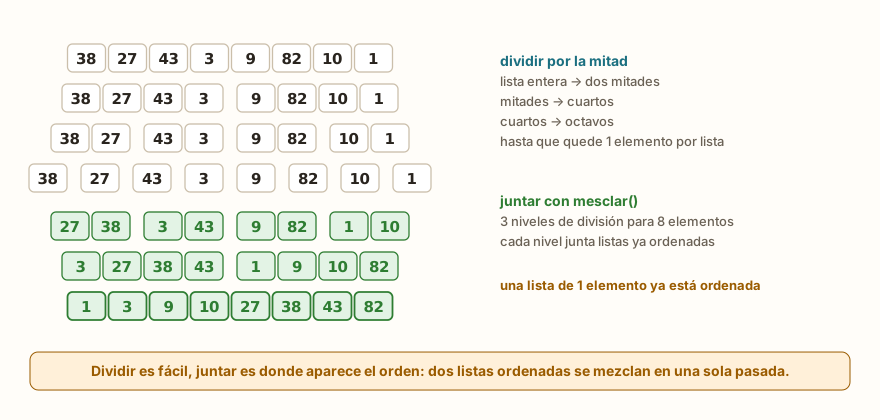
El merge sort se apoya en una operación simple: tomar dos listas ya ordenadas y juntarlas en una sola, también ordenada. Como cada una ya está en orden, basta mirar el frente de las dos, tomar la menor y avanzar en esa lista. Es la mezcla, y el resto del algoritmo es solo dividir la lista hasta que cada pedazo tenga un elemento, lo que garantiza que la mezcla siempre reciba listas ordenadas.
def mesclar(a, b):
    resultado = []
    i = 0
    j = 0
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            resultado.append(a[i])
            i += 1
        else:
            resultado.append(b[j])
            j += 1
    resultado.extend(a[i:])
    resultado.extend(b[j:])
    return resultado

print(mesclar([1, 4, 7], [2, 3, 9, 10]))
print(mesclar([], [1, 2]), mesclar([5], []), mesclar([], []), mesclar([2, 2], [2]))

def merge_sort(lista):
    if len(lista) <= 1:
        return lista
    meio = len(lista) // 2
    esquerda = merge_sort(lista[:meio])
    direita = merge_sort(lista[meio:])
    return mesclar(esquerda, direita)

print(merge_sort([38, 27, 43, 3, 9, 82, 10]))
print(merge_sort([3, 3, 1]), merge_sort([]), merge_sort([7]), merge_sort([1, 2, 3]))
original = [5, 2, 4, 1]
print(merge_sort(original), original)

def merge_sort_trace(lista, nivel=0):
    print("  " * nivel + "dividir", lista)
    if len(lista) <= 1:
        return lista
    meio = len(lista) // 2
    esq = merge_sort_trace(lista[:meio], nivel + 1)
    dir = merge_sort_trace(lista[meio:], nivel + 1)
    r = mesclar(esq, dir)
    print("  " * nivel + "juntar", r)
    return r
merge_sort_trace([38, 27, 43, 3])
print("fin")La salida empieza con [1, 2, 3, 4, 7, 9, 10] y [1, 2] [5] [] [2, 2, 2]. Después vienen [3, 9, 10, 27, 38, 43, 82], [1, 3, 3] [] [7] [1, 2, 3] y [1, 2, 4, 5] [5, 2, 4, 1]. El rastro de la última función es:
dividir [38, 27, 43, 3]
  dividir [38, 27]
    dividir [38]
    dividir [27]
  juntar [27, 38]
  dividir [43, 3]
    dividir [43]
    dividir [3]
  juntar [3, 43]
juntar [3, 27, 38, 43]Y por último fin.
La función mesclar usa dos índices, i para la lista a y j para la b, como dos dedos corriendo sobre dos filas ordenadas. Mientras los dos dedos están dentro de las listas, se compara a[i] con b[j], el menor va al resultado, y el dedo de esa lista avanza. Cuando una de las listas se acaba, sobra el resto de la otra, que ya está en orden y solo necesita copiarse: es lo que hacen las dos líneas con extend, a[i:] y b[j:]. Una de las dos rebanadas es siempre vacía. La comparación usa <=, y no <, para que, en caso de empate, el elemento de la lista de la izquierda salga primero, lo que mantiene la ordenación estable.
La segunda línea de pruebas muestra los casos de borde: una lista vacía, las dos vacías, y valores repetidos. Todos funcionan.
La función merge_sort es corta, y cada línea tiene un papel:
if len(lista) <= 1: return listaes el caso base de la recursión. Una lista con cero o un elemento ya está ordenada, y no hay más que dividir.meio = len(lista) // 2encuentra el punto de corte.merge_sort(lista[:meio])ymerge_sort(lista[meio:])ordenan cada mitad, llamándose a sí misma con una lista menor. Cada llamada divide de nuevo, hasta llegar a las listas de un elemento.return mesclar(esquerda, direita)junta las dos mitades, que ya vuelven ordenadas.
El rastro con sangrías muestra el orden en que ocurren las cosas. La lista [38, 27, 43, 3] se divide en [38, 27] y [43, 3], cada una en dos elementos sueltos. Solo cuando se llega a las listas de un elemento empieza el trabajo de juntar: [38] con [27] da [27, 38], [43] con [3] da [3, 43], y, por último, las dos dan [3, 27, 38, 43]. Fíjate en que el print("juntar") solo aparece después de que terminan las llamadas hijas, lo que es la recursión en acción.
Un detalle importante: el merge sort no altera la lista original. Las rebanadas lista[:meio] y lista[meio:] crean listas nuevas, y el resultado es una lista nueva. Por eso original sigue siendo [5, 2, 4, 1] después de la ordenación. Es lo opuesto del sort() de las listas, que altera en el lugar.
La IA que recuerda tu vida y vive en tu ordenador
- Memoria a largo plazo con la fuente de cada respuesta
- Funciona sin conexión: tus datos se quedan en tu PC
- Lee PDF, diapositivas, fotos y grabaciones de reuniones
Plan Esencial gratis para siempre
Quick sort: elegir un pivote

El quick sort hace lo contrario del merge sort: la parte difícil es dividir, y juntar es solo concatenar. Se elige un elemento, el pivote, y se separan todos los demás en tres grupos: los menores que el pivote, los iguales y los mayores. El pivote y sus iguales ya están en el lugar correcto. Basta ordenar, de la misma manera, el grupo de los menores y el de los mayores, y juntar todo en el orden menores + iguais + maiores.
lista = [7, 2, 9, 4, 6, 1, 8]
pivo = lista[len(lista) // 2]
menores = [x for x in lista if x < pivo]
iguais = [x for x in lista if x == pivo]
maiores = [x for x in lista if x > pivo]
print(pivo, menores, iguais, maiores)
def quick_sort(lista):
    if len(lista) <= 1:
        return lista
    pivo = lista[len(lista) // 2]
    menores = [x for x in lista if x < pivo]
    iguais = [x for x in lista if x == pivo]
    maiores = [x for x in lista if x > pivo]
    return quick_sort(menores) + iguais + quick_sort(maiores)
print(quick_sort(menores), quick_sort(maiores), quick_sort(lista))
print("fin")La salida es 4 [2, 1] [4] [7, 9, 6, 8], después [1, 2] [6, 7, 8, 9] [1, 2, 4, 6, 7, 8, 9] y por último fin. Es exactamente lo que muestra la figura: el pivote es el 4, el elemento del medio, los menores son [2, 1], los mayores son [7, 9, 6, 8], y cada lado se ordena solo.
La versión con comprensiones es la más legible, y basta una función de pocas líneas:
def quick_sort(lista):
    if len(lista) <= 1:
        return lista
    pivo = lista[len(lista) // 2]
    menores = [x for x in lista if x < pivo]
    iguais = [x for x in lista if x == pivo]
    maiores = [x for x in lista if x > pivo]
    return quick_sort(menores) + iguais + quick_sort(maiores)

print(quick_sort([38, 27, 43, 3, 9, 82, 10]))
print(quick_sort([3, 3, 1]), quick_sort([]), quick_sort([7]), quick_sort([1, 2, 3]), quick_sort([5, 5, 5]))
original = [5, 2, 4, 1]
print(quick_sort(original), original)

def quick_trace(lista, nivel=0):
    if len(lista) <= 1:
        print("  " * nivel + "listo", lista)
        return lista
    pivo = lista[len(lista) // 2]
    menores = [x for x in lista if x < pivo]
    iguais = [x for x in lista if x == pivo]
    maiores = [x for x in lista if x > pivo]
    print("  " * nivel + "pivote", pivo, "menores", menores, "iguales", iguais, "mayores", maiores)
    return quick_trace(menores, nivel + 1) + iguais + quick_trace(maiores, nivel + 1)
quick_trace([38, 27, 43, 3, 9, 82, 10])

def particionar(lista, baixo, alto):
    pivo = lista[alto]
    i = baixo
    for j in range(baixo, alto):
        if lista[j] < pivo:
            lista[i], lista[j] = lista[j], lista[i]
            i += 1
    lista[i], lista[alto] = lista[alto], lista[i]
    return i

def quick_no_lugar(lista, baixo, alto):
    if baixo < alto:
        p = particionar(lista, baixo, alto)
        quick_no_lugar(lista, baixo, p - 1)
        quick_no_lugar(lista, p + 1, alto)

dados = [38, 27, 43, 3, 9, 82, 10]
quick_no_lugar(dados, 0, len(dados) - 1)
print(dados)
print("fin")La salida empieza con [3, 9, 10, 27, 38, 43, 82], después [1, 3, 3] [] [7] [1, 2, 3] [5, 5, 5] y [1, 2, 4, 5] [5, 2, 4, 1]. El rastro del quick_trace es:
pivote 3 menores [] iguales [3] mayores [38, 27, 43, 9, 82, 10]
  listo []
  pivote 9 menores [] iguales [9] mayores [38, 27, 43, 82, 10]
    listo []
    pivote 43 menores [38, 27, 10] iguales [43] mayores [82]
      pivote 27 menores [10] iguales [27] mayores [38]
        listo [10]
        listo [38]
listo [82]Después vienen [3, 9, 10, 27, 38, 43, 82] de la versión en el lugar y fin.
La función quick_sort tiene el mismo diseño del merge sort: el caso base es la lista con a lo sumo un elemento, y el paso recursivo llama a la función para los dos lados. La diferencia es que aquí la lista no se corta por la mitad de la posición, sino por el valor del pivote. El uso de tres listas, con iguais aparte, es lo que hace que la función maneje bien los valores repetidos, como [5, 5, 5], y evita un error silencioso que veremos más adelante.
El rastro tiene una lección. En la primera llamada, el elemento del medio es el 3, que por casualidad es el menor valor de la lista. La lista de los menores queda vacía, y la de los mayores tiene casi todo, seis elementos de siete. La división fue desigual: poca ganancia. En la llamada siguiente ocurre de nuevo, con el pivote 9. Solo después la división queda razonable. Cuando el pivote cae cerca del medio de los valores, las dos mitades tienen tamaños parecidos y el algoritmo es rápido. Cuando cae cerca de un extremo, cada paso quita solo uno o dos elementos, y el algoritmo se vuelve, en la práctica, tan lento como los simples. La elección del pivote es, por lo tanto, la decisión central del quick sort.
La versión quick_no_lugar muestra la variante clásica, que ordena la propia lista sin crear listas nuevas. La función particionar usa el último elemento como pivote y reorganiza el tramo de baixo a alto de modo que los menores queden a la izquierda, el pivote en el medio y los mayores a la derecha. La variable i marca dónde va el próximo "menor". Al final, el pivote se intercambia a la posición i, que es su posición definitiva, y la función devuelve esa posición. La recursión entonces ordena los dos tramos, sin incluir el pivote. Es más económica en memoria, pero exige cuidado con los índices.
Cuánto cuestan

comparacoes = 0
def mesclar(a, b):
    global comparacoes
    resultado = []
    i = 0
    j = 0
    while i < len(a) and j < len(b):
        comparacoes += 1
        if a[i] <= b[j]:
            resultado.append(a[i])
            i += 1
        else:
            resultado.append(b[j])
            j += 1
    resultado.extend(a[i:])
    resultado.extend(b[j:])
    return resultado
def merge_sort(lista):
    if len(lista) <= 1:
        return lista
    meio = len(lista) // 2
    return mesclar(merge_sort(lista[:meio]), merge_sort(lista[meio:]))
def insertion_comparacoes(lista):
    c = 0
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        while j >= 0:
            c += 1
            if lista[j] > chave:
                lista[j + 1] = lista[j]
                j -= 1
            else:
                break
        lista[j + 1] = chave
    return c
for n in [8, 16, 100, 1000]:
    inv = list(range(n, 0, -1))
    ord_ = list(range(1, n + 1))
    comparacoes = 0
    r1 = merge_sort(inv)
    ci = comparacoes
    comparacoes = 0
    r2 = merge_sort(ord_)
    co = comparacoes
    print(n, "merge invertida", ci, "ordenada", co, "| insertion invertida", insertion_comparacoes(inv[:]) if n <= 100 else "-")
print("fin")La salida tiene cuatro líneas: 8 merge invertida 12 ordenada 12 | insertion invertida 28, 16 merge invertida 32 ordenada 32 | insertion invertida 120, 100 merge invertida 356 ordenada 316 | insertion invertida 4950 y 1000 merge invertida 5044 ordenada 4932 | insertion invertida -, seguidas de fin. Para 1000 elementos, el insertion no se midió, y el - lo marca. La cuenta por la fórmula, n * (n - 1) / 2, da 499 500 comparaciones, cerca de cien veces más que las 5044 del merge sort.
El merge sort tiene un comportamiento muy regular. Hay log2(n) niveles de división, aproximadamente: 3 para 8 elementos, 4 para 16, 7 para 100 y 10 para 1000. En cada nivel, la mezcla pasa por todos los elementos una vez, lo que da algo cercano a n comparaciones por nivel. El total queda en el orden de n * log2(n): para 100 elementos, ese producto da cerca de 660, y las 356 comparaciones medidas quedan por debajo. El orden inicial de la lista casi no importa para el merge sort: 356 contra 316 comparaciones para la lista invertida y la ordenada.
Comparar con el insertion muestra la ganancia. Con 8 elementos, la diferencia es pequeña, 12 contra 28. Con 100, son 356 contra 4950. Cada vez que la lista se duplica, el merge sort hace un poco más que el doble de trabajo, y el insertion lo cuadruplica. Esa diferencia de ritmo es el tema del próximo artículo, sobre complejidad de algoritmos.
El quick sort tiene un costo parecido cuando el pivote divide bien, y el mismo comportamiento cuadrático de los algoritmos simples cuando divide mal. Como el resultado depende de la lista y del pivote, no vamos a tabular números para él aquí. La próxima sección muestra el problema en la práctica.
El límite de recursión y el peor caso del quick sort
El artículo sobre recursividad mostró que MicroPython tiene un límite de recursión mucho menor que el del Python de computador, y que el simulador reproduce eso: en torno a 50 llamadas anidadas. Para el merge sort, eso no es un problema, porque la profundidad es log2(n): con mil elementos, 10 niveles. Para el quick sort, depende del pivote:
def quick_sort_primeiro(lista):
    if len(lista) <= 1:
        return lista
    pivo = lista[0]
    menores = [x for x in lista[1:] if x < pivo]
    maiores = [x for x in lista[1:] if x >= pivo]
    return quick_sort_primeiro(menores) + [pivo] + quick_sort_primeiro(maiores)
ultimo = 0
for n in range(40, 70):
    try:
        quick_sort_primeiro(list(range(n)))
        ultimo = n
    except RuntimeError:
        print("primer error en n =", n, "último ok =", ultimo)
        break
print("fin")La salida es primer error en n = 51 último ok = 50 y fin.
Esta versión usa el primer elemento como pivote, y la prueba es con listas ya ordenadas, de 40 a 69 elementos. En una lista ordenada, el primer elemento es siempre el menor: la lista de los menores queda vacía, y la de los mayores contiene todo el resto. Cada llamada quita un elemento, y la profundidad de la recursión pasa a ser n. En el simulador, la lista de 50 elementos pasa, y la de 51 revienta el límite con RuntimeError, como muestra la salida. En el Python de computador, el límite estándar es de unas mil llamadas, y una lista de 100 elementos pasa sin error.
Esto muestra dos cosas. Primero, el peor caso del quick sort no es teoría: es una lista ordenada con el pivote en el extremo, justamente la lista más común de recibir. Segundo, en la ESP32 el límite de recursión acerca mucho más ese peor caso que en el computador. Con el pivote en el medio, como en la versión de las comprensiones, la lista ordenada es el mejor caso, porque el elemento del medio divide la lista en dos partes iguales. Por eso el quick_sort anterior ordena sin problemas una lista invertida de mil elementos, y el merge sort también, con 10 niveles.
Quien necesita seguridad elige un pivote mejor, como el del medio, o la mediana de tres (el valor del medio entre el primero, el del centro y el último). Pero el punto de partida más simple es este: para listas pequeñas y ordenaciones comunes, usa sorted(). Los dos algoritmos de este artículo son para entender la idea.
Del programa al semestre planificado
- Plan de enseñanza y calendario montados solos
- Diario de clases listo para pegar en el SIGA
- Diapositivas y listas de ejercicios con solucionario
Versión Community gratis · Windows
En la ESP32: juntar dos registros ordenados por tiempo
Mezclar dos listas ordenadas es una operación útil por sí sola, sin necesitar el merge sort entero. Imagina dos sensores que registran lecturas con el instante de cada una, cada uno con su lista ya en orden de tiempo, y un programa que necesita un registro solo, en orden cronológico:
def mesclar(a, b):
    resultado = []
    i = 0
    j = 0
    while i < len(a) and j < len(b):
        if a[i][0] <= b[j][0]:
            resultado.append(a[i])
            i += 1
        else:
            resultado.append(b[j])
            j += 1
    resultado.extend(a[i:])
    resultado.extend(b[j:])
    return resultado
sensor_a = [(1, "A:21.5"), (4, "A:21.7"), (7, "A:22.0")]
sensor_b = [(2, "B:55%"), (3, "B:56%"), (9, "B:54%")]
for t, msg in mesclar(sensor_a, sensor_b):
    print(t, msg)
log = mesclar(sensor_a, [(4, "B:58%")])
print(log)
print("fin")La salida es 1 A:21.5, 2 B:55%, 3 B:56%, 4 A:21.7, 7 A:22.0, 9 B:54%, después [(1, 'A:21.5'), (4, 'A:21.7'), (4, 'B:58%'), (7, 'A:22.0')] y fin.
La función es la misma, con un cambio: cada ítem es una tupla (instante, mensaje), y la comparación mira el primer campo, a[i][0] contra b[j][0]. El resultado es el registro de los dos sensores intercalado por tiempo. La última prueba muestra el desempate: cuando dos registros tienen el mismo instante, 4, el de la lista a sale primero, gracias al <=. Lo mismo vale para juntar registros de archivos, de dos tareas o de dos fuentes de eventos. Los sensores usados en los artículos de DHT22, HC-SR04 y PIR son ejemplos de fuentes que pueden generar esos registros.
Hay una salvedad sobre la memoria. El merge sort y la versión del quick sort con comprensiones crean listas nuevas en cada división, y la memoria de una placa es pequeña. Para listas de decenas de ítems, esto no pesa. Para cientos o miles, conviene pensar en la versión en el lugar, o simplemente en sorted().
Errores comunes
El primero es olvidar el caso base:
def merge_sort(lista):
    meio = len(lista) // 2
    return merge_sort(lista[:meio]) + merge_sort(lista[meio:])
print(merge_sort([3, 1, 2]))RuntimeError: maximum recursion depth exceededAntes de esa línea, el simulador imprime unas 50 líneas repetidas de File "main.py", line 3, in merge_sort. La función divide y se llama a sí misma sin detenerse nunca: una lista de un elemento se vuelve una lista vacía, que se vuelve otra lista vacía, para siempre. En el Python de computador, el mensaje es RecursionError: maximum recursion depth exceeded while calling a Python object. La corrección es el if len(lista) <= 1: return lista.
El segundo es un bucle de mezcla sin la condición de parada:
def mesclar(a, b):
    resultado = []
    i = j = 0
    while True:
        if a[i] <= b[j]:
            resultado.append(a[i]); i += 1
        else:
            resultado.append(b[j]); j += 1
    return resultado
print(mesclar([1], [2]))IndexError: list index out of rangeCon while True, los índices crecen hasta pasar del final de una de las listas, y el programa falla. La condición correcta es while i < len(a) and j < len(b), seguida del extend con lo que sobró.
Trampas silenciosas
Los errores más peligrosos de los dos algoritmos son los que no dan mensaje:
def quick_sort_ruim(lista):
    if len(lista) <= 1:
        return lista
    pivo = lista[0]
    menores = [x for x in lista if x < pivo]
    maiores = [x for x in lista if x > pivo]
    return quick_sort_ruim(menores) + [pivo] + quick_sort_ruim(maiores)
print(quick_sort_ruim([3, 1, 3, 2, 3]))
def mesclar(a, b):
    r = []
    i = j = 0
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            r.append(a[i]); i += 1
        else:
            r.append(b[j]); j += 1
    return r
print(mesclar([1, 4, 7], [2, 3, 9, 10]))
def mesclar_certa(a, b):
    r = []
    i = j = 0
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            r.append(a[i]); i += 1
        else:
            r.append(b[j]); j += 1
    return r + a[i:] + b[j:]
print(mesclar_certa([5, 1], [4, 2]))
print("fin")La salida es [1, 2, 3], después [1, 2, 3, 4, 7], después [4, 2, 5, 1] y por último fin.
En el primer caso, el quick_sort_ruim separa solo menores y mayores, sin guardar los iguales. La lista [3, 1, 3, 2, 3] tiene cinco elementos, y el resultado, tres: los dos 3 repetidos desaparecieron, porque ni x < pivo ni x > pivo los captura. El resultado parece ordenado y tiene el tamaño equivocado. Por eso la versión correcta tiene la lista iguais.
En el segundo, la mesclar olvida copiar lo que sobró después de que una de las listas se acaba. Los valores 9 y 10, que quedaban en b, desaparecieron: el resultado tiene cinco elementos, y las listas sumaban siete. La versión correcta termina con r + a[i:] + b[j:].
El tercero muestra una exigencia que la función no verifica: la mesclar supone que las dos listas ya están ordenadas. Con [5, 1] y [4, 2], que no lo están, el resultado es [4, 2, 5, 1], sin error y sin orden. Mezclar no ordena: junta dos cosas que ya estaban en orden.
Lo que suele aparecer en el aula
Son patrones que se repiten en quien aprende estos algoritmos. No son el relato de un grupo específico.
Olvidar el caso base. La función se llama a sí misma hasta reventar. La pregunta que ayuda es: ¿cuál es la lista más pequeña que sé ordenar sin hacer nada?
Olvidar juntar el resultado. Escribir merge_sort(lista[:meio]) sin guardar ni usar lo que devuelve. La función corre, pero la lista ordenada se pierde, porque el merge sort de esta forma no altera la lista en el lugar.
Perder lo que sobró en la mezcla. El resultado viene sin los mayores elementos, y quien mira solo el comienzo de la lista no lo nota. Comparar el len del resultado con la suma de los tamaños es una prueba rápida.
Perder los repetidos en el quick sort. Separar solo menores y mayores, sin una lista de iguales. El error solo aparece con valores repetidos, y las listas de prueba suelen tener todos los valores distintos.
Creer que el quick sort es siempre rápido. Quien solo prueba con listas mezcladas nunca ve el peor caso. Una lista ya ordenada, con el pivote en el primer elemento, es la prueba que lo revela.
Esperar que la recursión funcione para cualquier tamaño. En el computador, el límite es de unas mil llamadas. En la placa, y en el simulador, el límite de recursión es bastante menor, y el mismo código puede fallar.
Confundir mezclar con ordenar. La mezcla solo funciona con listas ordenadas. Llamar a mesclar con listas desordenadas devuelve una lista desordenada.
Querer usar estos algoritmos en lugar del sorted(). En la práctica, es al revés: se escribe a mano para entender, y se usa la función lista en el programa.
Ejercicio: ordenar con merge sort y hallar la mediana
Escribe un programa que lea la cantidad n de números, después los n valores, los ordene con merge sort y muestre la lista antes y después y la mediana. El bloque usa entradas= para entregar 6 números: 38, 27, 43, 3, 9 y 82.
def mesclar(a, b):
    resultado = []
    i = 0
    j = 0
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            resultado.append(a[i])
            i += 1
        else:
            resultado.append(b[j])
            j += 1
    resultado.extend(a[i:])
    resultado.extend(b[j:])
    return resultado
def merge_sort(lista):
    if len(lista) <= 1:
        return lista
    meio = len(lista) // 2
    return mesclar(merge_sort(lista[:meio]), merge_sort(lista[meio:]))
n = int(input())
valores = []
for i in range(n):
    valores.append(int(input()))
ordenados = merge_sort(valores)
print("antes", valores)
print("después", ordenados)
print("mediana", ordenados[n // 2])
print("fin")El simulador repite en la salida los valores escritos, uno por línea, y después vienen antes [38, 27, 43, 3, 9, 82], después [3, 9, 27, 38, 43, 82], mediana 38 y fin.
El programa mantiene la lista valores intacta, porque el merge sort devuelve una lista nueva, y muestra las dos. La mediana, para una cantidad par de números como estos seis, es el promedio de los dos del medio, 27 y 38. La línea ordenados[n // 2] toma solo el elemento de la posición 3, el 38, lo que sirve para cantidades impares y es una aproximación para las pares. Para practicar, prueba: calcular la mediana correcta para cantidades pares, con el promedio de los dos valores centrales; cambiar el merge sort por sorted() y comparar; ordenar de mayor a menor, cambiando el <= por >= en la mezcla; y contar cuántas comparaciones hace la mezcla.
Preguntas frecuentes
¿El merge sort es mejor que el quick sort? Depende. El merge sort tiene un costo regular y es estable, pero usa listas nuevas. El quick sort en el lugar usa poca memoria, pero puede degenerar con un pivote malo.
¿Por qué el merge sort es estable? Porque, en el empate, la mezcla toma primero el elemento de la lista de la izquierda, con <=. Así los iguales mantienen el orden en que entraron.
¿Qué pivote debo elegir en el quick sort? El elemento del medio es una buena elección simple, y funciona bien con listas ya ordenadas. Más robusta es la mediana de tres. El primer o el último elemento es la peor elección para listas que suelen venir ordenadas.
¿El sorted() usa uno de estos algoritmos? Python usa un algoritmo propio, híbrido, que combina ideas de mezcla y de inserción. El de MicroPython es otro, y no es estable, como mostró el artículo sobre lambda, map, filter y sorted.
¿Para qué la recursión, si hay bucles? Porque la idea de dividir y resolver partes menores es naturalmente recursiva. Es posible escribir los dos sin recursión, con una pila propia, pero el código queda bastante más largo.
¿Estos algoritmos sirven para listas pequeñas? Sirven, pero no compensan. Para pocos elementos, el insertion sort o el sorted() son más simples e igualmente rápidos.
Para continuar
Los desafíos Suma de la lista, Mayor de la lista y Lista al revés practican el recorrido y el armado de listas nuevas que usa la mezcla. Para repasar la base, vale la pena pasar por los artículos sobre recursividad, funciones con def, bubble y selection sort e insertion sort, y por la ruta de lógica.
El próximo artículo cierra esta parte con la complejidad de algoritmos, la notación Big-O: cómo darle nombre a lo que se vio aquí, el trabajo que crece con el cuadrado de n en los algoritmos simples y con n * log2(n) en el merge sort.