Fundamentos
Insertion sort en Python y cuándo usar sorted()
Aprende el insertion sort, compáralo con bubble y selection, mira por qué es estable y cuándo usar sorted() y sort() en lugar de escribirlo a mano.
Por Prof. Rodrigo Faustino · Actualizado el · 16 min de lectura
Métricas de este artículo
- Palabras
- 3171
- Caracteres
- 17.746
- Tiempo de lectura
- ~16 min
Quien juega a las cartas conoce el insertion sort sin saberlo. Al recibir cada carta, la persona la encaja en el lugar correcto entre las que ya tiene en la mano, desplazando las mayores para abrir espacio. La mano está siempre ordenada, y cada carta nueva solo necesita encontrar su posición. Es exactamente lo que el algoritmo hace con una lista: la parte de la izquierda queda ordenada, y el siguiente elemento se inserta en ella.
Este artículo es el tercero de los algoritmos simples de ordenación, después del bubble sort y el selection sort. Muestra cómo funciona el insertion sort, por qué anda tan bien en listas casi ordenadas, por qué es estable, y cierra la pregunta que quedó desde el principio: si Python ya tiene sorted() y sort(), ¿cuándo vale la pena escribir la ordenación a mano? Todos los ejemplos corrieron en el simulador, y los resultados citados son los que él produce.
Insertion sort: encajar de a uno

El algoritmo empieza considerando que el primer elemento, solo, ya es una lista ordenada. Después toma el segundo y lo encaja en el lugar correcto, después el tercero, y así hasta el último. Para encajar, se guarda el elemento en una variable, la clave, y se anda hacia atrás por la parte ordenada, empujando una casilla a la derecha cada valor mayor que la clave, hasta encontrar su lugar.
def insertion(lista):
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        while j >= 0 and lista[j] > chave:
            lista[j + 1] = lista[j]
            j -= 1
        lista[j + 1] = chave
    return lista

print(insertion([5, 2, 4, 6, 1, 3]))
print(insertion([3, 3, 1]), insertion([]), insertion([7]), insertion([1, 2, 3]))

def insertion_passos(lista):
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        deslocou = 0
        while j >= 0 and lista[j] > chave:
            lista[j + 1] = lista[j]
            j -= 1
            deslocou += 1
        lista[j + 1] = chave
        print("i", i, "clave", chave, "desplazó", deslocou, lista)
    return lista
insertion_passos([5, 2, 4, 6, 1, 3])

def insertion_conta(lista):
    comparacoes = 0
    deslocamentos = 0
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        while j >= 0:
            comparacoes += 1
            if lista[j] > chave:
                lista[j + 1] = lista[j]
                deslocamentos += 1
                j -= 1
            else:
                break
        lista[j + 1] = chave
    return comparacoes, deslocamentos
print(insertion_conta([5, 2, 4, 6, 1, 3]))
print(insertion_conta([1, 2, 3, 4, 5]))
print(insertion_conta([5, 4, 3, 2, 1]))
print("fin")La salida empieza con [1, 2, 3, 4, 5, 6] y [1, 3, 3] [] [7] [1, 2, 3]. El paso a paso es i 1 clave 2 desplazó 1 [2, 5, 4, 6, 1, 3], i 2 clave 4 desplazó 1 [2, 4, 5, 6, 1, 3], i 3 clave 6 desplazó 0 [2, 4, 5, 6, 1, 3], i 4 clave 1 desplazó 4 [1, 2, 4, 5, 6, 3] e i 5 clave 3 desplazó 3 [1, 2, 3, 4, 5, 6]. Los conteos son (12, 9), (4, 0) y (10, 10), y por último fin.
Vale leer la función insertion línea por línea:
for i in range(1, len(lista))recorre los elementos a partir del segundo. El de índice 0 no necesita tratarse, ya que solo está ordenado.chave = lista[i]guarda el valor que se va a encajar. Este paso es esencial, y la próxima sección muestra qué ocurre sin él.j = i - 1apunta al último elemento de la parte ordenada, el vecino inmediato de la clave.while j >= 0 and lista[j] > chaveanda hacia atrás mientras todavía haya elementos y mientras el elemento mirado sea mayor que la clave. El orden de las dos condiciones importa: elj >= 0va primero porque, sijfuera-1, ellista[j]miraría el último elemento de la lista, y no un elemento inexistente.lista[j + 1] = lista[j]desplaza el mayor una casilla a la derecha, yj -= 1pasa al siguiente.lista[j + 1] = chavegraba la clave en el hueco que sobró. Cuando el bucle se detiene,japunta al primer elemento que no es mayor que la clave, o a-1si no hay ninguno, y el lugar de la clave queda justo después.
Desplazar en lugar de intercambiar
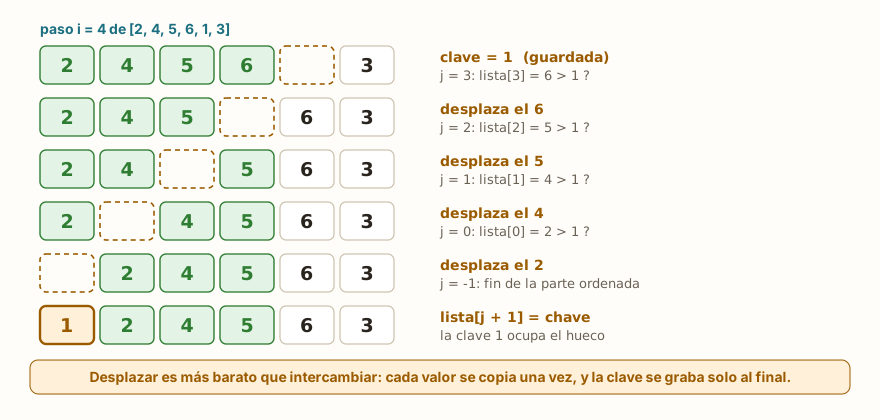
Hay una diferencia sutil respecto del bubble sort. El bubble intercambia dos vecinos en cada paso, lo que mueve dos posiciones. El insertion desplaza: copia un valor a la posición de al lado, y solo al final graba la clave. La figura muestra el paso i = 4 de la lista de ejemplo, donde la clave es el 1. El 1 se guarda, lo que deja un hueco en la posición 4. El 6 va al hueco, el 5 al hueco que dejó el 6, y así sucesivamente, hasta que el hueco llega a la posición 0. Entonces la clave cae en él. Cada valor se copia una vez, y la clave se escribe una vez, lo que da menos trabajo de escritura que una secuencia de intercambios.
Los resultados de la función insertion_passos muestran cómo varía el trabajo. El 6, en el paso i = 3, ya estaba en el lugar correcto y desplazó cero valores. El 1, en el paso siguiente, era menor que todos los de la parte ordenada y fue hasta el comienzo, desplazando cuatro. El total, 9 desplazamientos y 12 comparaciones, es bastante menor que el máximo posible.
La IA que recuerda tu vida y vive en tu ordenador
- Memoria a largo plazo con la fuente de cada respuesta
- Funciona sin conexión: tus datos se quedan en tu PC
- Lee PDF, diapositivas, fotos y grabaciones de reuniones
Plan Esencial gratis para siempre
Los tres lado a lado
def bubble(lista):
    c = t = 0
    n = len(lista)
    for i in range(n - 1):
        trocou = False
        for j in range(n - 1 - i):
            c += 1
            if lista[j] > lista[j + 1]:
                lista[j], lista[j + 1] = lista[j + 1], lista[j]
                t += 1
                trocou = True
        if not trocou:
            break
    return c, t
def selection(lista):
    c = t = 0
    n = len(lista)
    for i in range(n - 1):
        m = i
        for j in range(i + 1, n):
            c += 1
            if lista[j] < lista[m]:
                m = j
        if m != i:
            lista[i], lista[m] = lista[m], lista[i]
            t += 1
    return c, t
def insertion(lista):
    c = d = 0
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        while j >= 0:
            c += 1
            if lista[j] > chave:
                lista[j + 1] = lista[j]
                d += 1
                j -= 1
            else:
                break
        lista[j + 1] = chave
    return c, d
n = 100
ordenada = list(range(1, n + 1))
quase = list(range(1, n + 1))
quase[10], quase[11] = quase[11], quase[10]
quase[50], quase[51] = quase[51], quase[50]
quase[90], quase[91] = quase[91], quase[90]
invertida = list(range(n, 0, -1))
for nome, base in [("ordenada", ordenada), ("casi", quase), ("invertida", invertida)]:
    print(nome, "bubble", bubble(base[:]), "selection", selection(base[:]), "insertion", insertion(base[:]))
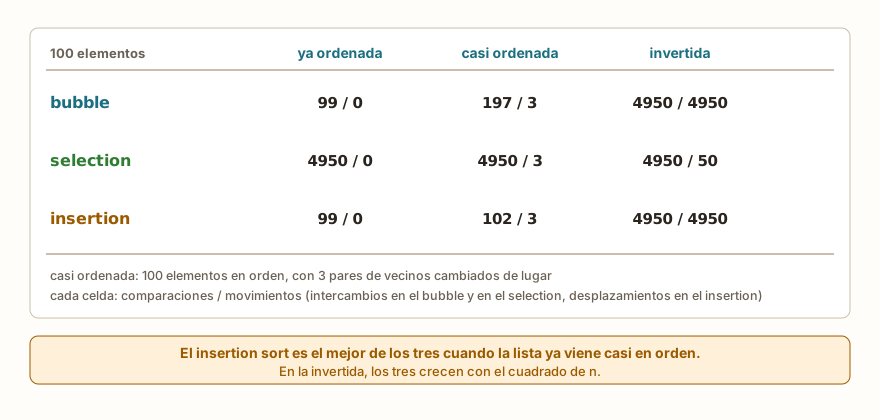
print("fin")La salida tiene tres líneas: ordenada bubble (99, 0) selection (4950, 0) insertion (99, 0), después casi bubble (197, 3) selection (4950, 3) insertion (102, 3), después invertida bubble (4950, 4950) selection (4950, 50) insertion (4950, 4950), y por último fin. En cada par, el primer número es el de comparaciones y el segundo, el de movimientos: intercambios en el bubble y en el selection, desplazamientos en el insertion.
El caso del medio, casi ordenada, es el más revelador. La lista tiene 100 elementos en orden, con tres pares de vecinos cambiados de lugar. El insertion hace 102 comparaciones, una por elemento más tres de ajuste. El bubble con parada anticipada necesita más pasadas y hace 197. El selection, que siempre barre todo, hace 4950. Los tres hacen solo 3 movimientos, porque solo hay tres pares fuera de lugar.
Las listas casi ordenadas aparecen más de lo que parece. Un registro de lecturas al que llega un valor nuevo por vez, una lista que se ordenó ayer y recibió algunos ítems hoy, un ranking que cambia poco en cada ronda. En esos casos, el insertion sort hace un trabajo proporcional al tamaño del desorden, y no al tamaño de la lista.
En el peor caso, la lista invertida, los tres crecen con el cuadrado de n: 4950 comparaciones para 100 elementos. El selection todavía lleva la ventaja de intercambiar poco, 50 veces, y los otros dos mueven 4950 veces. Ninguno de los tres es una buena elección para listas grandes y desordenadas, y de eso se ocupa el próximo artículo.
Estabilidad: el insertion sort mantiene el orden de los empates
Una ordenación es estable cuando los elementos de igual clave salen en el mismo orden en que entraron. Esto importa cuando se ordena por un campo y se quiere que el resto del orden se conserve, como ordenar alumnos por nota y mantener el orden alfabético entre los que empatan. El artículo sobre lambda, map, filter y sorted mostró que el sorted() de MicroPython no es estable. El insertion sort escrito a mano, con la comparación > estricta, sí lo es:
def insertion_por(lista, chave_fn):
    for i in range(1, len(lista)):
        item = lista[i]
        k = chave_fn(item)
        j = i - 1
        while j >= 0 and chave_fn(lista[j]) > k:
            lista[j + 1] = lista[j]
            j -= 1
        lista[j + 1] = item
    return lista
palavras = ["pera", "uva", "banana", "kiwi"]
print(insertion_por(palavras[:], len))
print(sorted(palavras, key=len))
leituras = [("a", 12), ("b", 30), ("c", 12), ("d", 25), ("e", 12), ("f", 30)]
print(insertion_por(leituras[:], lambda t: t[1]))
print(sorted(leituras, key=lambda t: t[1]))
print(sorted(leituras, key=lambda t: (t[1], t[0])))
print("fin")En el simulador, la salida es ['uva', 'pera', 'kiwi', 'banana'], después ['uva', 'kiwi', 'pera', 'banana'], después [('a', 12), ('c', 12), ('e', 12), ('d', 25), ('b', 30), ('f', 30)], después [('e', 12), ('c', 12), ('a', 12), ('d', 25), ('f', 30), ('b', 30)], después [('a', 12), ('c', 12), ('e', 12), ('d', 25), ('b', 30), ('f', 30)] y fin.
Compara las líneas de a dos. El insertion_por mantiene pera antes de kiwi, y a, c y e en el orden original, que es el orden estable. El sorted() del simulador, que imita el de MicroPython, invierte, en estos ejemplos, los empates: kiwi antes de pera, y e, c, a. En el Python de computador, el sorted() da el mismo resultado que el insertion, y por eso el mismo programa da salidas diferentes en el computador y en la placa. La última línea muestra la salida para este problema: con una clave compuesta (t[1], t[0]), que desempata por el nombre, el sorted() da la misma respuesta en los dos lugares.
En la función insertion_por, el detalle que garantiza la estabilidad es el > estricto: el bucle solo desplaza elementos mayores que la clave. Los elementos iguales no se desplazan, y por eso la clave que acaba de llegar queda después de todos los iguales que ya estaban. La función también recibe la función de clave como argumento, chave_fn, y calcula chave_fn(item) una vez por elemento, la misma idea del key del sorted().
Insertar en una lista que ya está ordenada
El paso central del insertion sort, encajar un valor en una lista ordenada, sirve por sí solo. Cuando los datos llegan de a uno, como lecturas de un sensor, se puede mantener una lista siempre ordenada insertando cada valor en la posición correcta, sin ordenar todo otra vez:
def inserir_ordenado(lista, valor):
    pos = 0
    while pos < len(lista) and lista[pos] < valor:
        pos += 1
    lista.insert(pos, valor)

top = []
for v in [40, 15, 70, 25, 55, 10, 80]:
    inserir_ordenado(top, v)
    if len(top) > 3:
        top.pop(0)
    print(v, top)
print(top)
ordem = []
for v in [5, 1, 4, 2, 8]:
    inserir_ordenado(ordem, v)
print(ordem)
print("fin")La salida es 40 [40], 15 [15, 40], 70 [15, 40, 70], 25 [25, 40, 70], 55 [40, 55, 70], 10 [40, 55, 70], 80 [55, 70, 80], después [55, 70, 80], después [1, 2, 4, 5, 8] y fin.
La función inserir_ordenado busca la posición, con un bucle que avanza mientras los elementos sean menores que el valor, y usa el método insert(pos, valor), que coloca el valor en la posición indicada y empuja los siguientes a la derecha. El primer uso es un marcador de los 3 mayores valores: a cada lectura nueva, entra en la lista ordenada, y, si la lista pasa de 3, el pop(0) descarta el menor, que está al comienzo. La lista nunca guarda más de 3 valores, y termina con los tres mayores de la secuencia, [55, 70, 80]. Fíjate en que la lectura 10, demasiado pequeña, entró y fue descartada de inmediato.
El segundo uso muestra que repetir inserir_ordenado para cada elemento es el insertion sort: la lista ordem terminó ordenada, sin ninguna función de ordenación.
En la placa, esto interesa por dos razones. La lista queda siempre lista para consulta, lo que permite, por ejemplo, tomar la mediana en cualquier momento en el elemento del medio, como hizo el artículo anterior con un filtro de mediana. Y la memoria queda limitada, porque se guarda solo lo que interesa. Las lecturas de un sensor, como las de los artículos sobre sensores DHT22, HC-SR04 y PIR, son el uso natural.
Del programa al semestre planificado
- Plan de enseñanza y calendario montados solos
- Diario de clases listo para pegar en el SIGA
- Diapositivas y listas de ejercicios con solucionario
Versión Community gratis · Windows
Cuándo usar sorted() y sort()
En la práctica, casi siempre se usan las funciones listas. Ya están probadas, aceptan key y reverse, y ahorran el código. El cuadro de decisión es corto:
print(sorted("python"))
print(sorted((3, 1, 2)))
print(sorted({"b": 1, "a": 2}))
print(sorted({3, 1, 2}))
print(sorted([3, 1, 2], reverse=True))
d = {"ana": 8.5, "bia": 6.0, "caio": 9.0}
print(sorted(d.items(), key=lambda kv: kv[1]))
print(sorted(d, key=d.get, reverse=True))
nums = [4, 2, 9, 1]
print(min(nums), max(nums), nums)
print(sorted(nums) == nums, nums == sorted(nums))
copia = nums[:]
copia.sort()
print(copia, nums)
copia.sort(reverse=True)
print(copia)
print("fin")La salida es ['h', 'n', 'o', 'p', 't', 'y'], [1, 2, 3], ['a', 'b'], [1, 2, 3], [3, 2, 1], [('bia', 6.0), ('ana', 8.5), ('caio', 9.0)], ['caio', 'ana', 'bia'], 1 9 [4, 2, 9, 1], False False, [1, 2, 4, 9] [4, 2, 9, 1], [9, 4, 2, 1] y fin.
Lo que enseña cada trecho:
- El
sorted()acepta cualquier cosa que se recorra, como texto, tupla, diccionario y conjunto, y siempre devuelve una lista. Para un diccionario, ordena las claves. - El
sorted(..., reverse=True)ordena de mayor a menor. - Con
key, se ordena por un criterio. Eld.items()entrega pares(nombre, nota), y elkv[1]elige la nota. Elkey=d.getusa el propio método del diccionario como función de clave, y da los nombres del mejor al peor. - El
sorted()no altera la lista original: las líneas connumsmuestran que sigue siendo[4, 2, 9, 1]. En cambio, elsort()ordena en el lugar y devuelveNone, como muestra el uso en lacopia. - Para encontrar solo el menor o el mayor, el
miny elmaxbastan, y son más simples que ordenar todo.
La regla de elección, entonces, queda así:
- ¿Solo quieres la lista ordenada? Usa
sorted(lista), olista.sort()si no necesitas la original. - ¿Ordenar por un campo? Usa
key, y, si los empates importan, una clave compuesta, como se vio arriba. - ¿Solo el menor o el mayor? Usa
minomax, conkeysi hace falta. - ¿Los datos llegan de a uno y la lista debe estar siempre ordenada? Inserta cada valor con la idea del
inserir_ordenado. - ¿Quieres entender, o la regla de orden es poco común? Escríbelo a mano, como ejercicio, o cuando ningún
keyexprese el criterio.
Escribir el algoritmo a mano no es la elección para código de producción. Pero, después de haberlo escrito, es mucho más fácil entender qué hace el sorted(), por qué puede ser lento con una key pesada y por qué importa la estabilidad.
Errores comunes
El primero es ordenar valores de tipos diferentes:
print(sorted([3, "1", 2]))TypeError: unsupported types for __lt__: 'int', 'str'En el Python de computador, el mensaje es '<' not supported between instances of 'str' and 'int'. Suele aparecer cuando los valores vienen de input() y nadie los convirtió con int().
El segundo es pasar el reverse sin el nombre:
print(sorted([3, 1, 2], True))TypeError: must use keyword argument for key functionEn el Python de computador, el mensaje es sorted expected 1 argument, got 2. En los dos casos, el reverse y el key solo se pasan por nombre: sorted(lista, reverse=True).
El tercero es usar una función de clave que no sirve para los ítems:
nums = [3, 1, 2]
nums.sort(key=len)TypeError: object of type 'int' has no len()El len calcula el tamaño de textos y listas, y no de números. El mensaje es el mismo en el simulador y en el computador.
El cuarto es el clásico de guardar el resultado del sort():
lista = [3, 1, 2]
lista = lista.sort()
print(len(lista))TypeError: object of type 'NoneType' has no len()El sort() devuelve None, y la variable perdió la lista. El mensaje también es igual en los dos ambientes. La corrección es llamar a lista.sort() solo, en una línea, o usar lista = sorted(lista).
El quinto es pedir la ordenación de algo que no se recorre:
print(sorted(5))TypeError: 'int' object isn't iterableEn el computador, el mensaje es 'int' object is not iterable.
El sexto es olvidar el j >= 0 en el bucle del insertion sort:
def insertion_erro(lista):
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        while lista[j] > chave:
            lista[j + 1] = lista[j]
            j -= 1
        lista[j + 1] = chave
    return lista
print(insertion_erro([5, 2, 4]))IndexError: list index out of rangeSin la prueba, cuando la clave es menor que todos los elementos de la parte ordenada, j llega a -1 y sigue bajando. Los índices negativos de Python cuentan desde el final de la lista, y por eso el bucle mira elementos que no debería, hasta que j sale del alcance de la lista entera. Es un error que ocurre justo cuando la clave es el menor valor, y por eso una lista que solo tiene valores crecientes no lo revela.
Trampas silenciosas
Sin la variable chave, la función no da error y ordena mal:
def insertion_sem_chave(lista):
    for i in range(1, len(lista)):
        j = i - 1
        while j >= 0 and lista[j] > lista[j + 1]:
            lista[j + 1] = lista[j]
            j -= 1
    return lista
print(insertion_sem_chave([5, 2, 4, 6, 1, 3]))
print("fin")La salida es [5, 5, 5, 6, 6, 6] y fin. La función sobrescribe lista[j + 1] con lista[j] sin haber guardado el valor original en ningún lugar, y se pierde. El resultado tiene el tamaño correcto y parece "medio ordenado", pero el 2, el 4, el 1 y el 3 desaparecieron, y el 5 y el 6 se repiten. Es el mismo tipo de error del intercambio hecho con dos asignaciones, en el artículo anterior: para mover un valor sin perder el otro, hay que guardarlo antes. Aquí, quien lo guarda es la chave.
Lo que suele aparecer en el aula
Son patrones que se repiten en quien aprende el insertion sort. No son el relato de un grupo específico.
Olvidar la chave. Genera [5, 5, 5, 6, 6, 6] y la persona no entiende de dónde vinieron los repetidos. La pregunta que ayuda es: ¿dónde está guardado el valor que estoy moviendo?
El orden de las condiciones del while. Escribir lista[j] > chave and j >= 0. Cuando j vale -1, la primera condición ya mira lista[-1], el último elemento, y el resultado deja de ser confiable. La condición de límite va siempre primero.
Grabar la clave en el lugar equivocado. Escribir lista[j] = chave en lugar de lista[j + 1] = chave. Después del bucle, j apunta al elemento anterior al lugar de la clave, y la posición correcta es la siguiente.
Confundir sort() con sorted(). Quien usa lista = lista.sort() pierde la lista. Quien usa sorted(lista) sin guardar el resultado cree que la lista se ordenó, y sigue como estaba.
Esperar el mismo orden de los empates en el computador y en la placa. El programa pasa las pruebas en el computador y se comporta distinto en la ESP32. La clave compuesta, que elimina los empates, lo resuelve.
Creer que escribir a mano es "más correcto". Algunas personas prefieren el algoritmo propio por desconfiar del sorted(). Lo contrario suele ser verdad: la función lista tiene menos probabilidad de tener un error de límite.
Ordenar en cada lectura. Un programa que llama a sorted() sobre toda la lista en cada lectura nueva de un sensor rehace todo el trabajo. Insertar el valor nuevo en la posición correcta, como en el marcador de los 3 mayores, hace mucho menos.
Mezclar tipos en la lista. Un valor que llegó como texto en medio de números derriba la ordenación con TypeError. Convertir en la lectura lo evita.
Ejercicio: ordenar palabras por tamaño
Escribe un programa que lea la cantidad n de palabras, después las n palabras, y las ordene por tamaño con insertion sort, mostrando la lista y la más corta y la más larga. El bloque usa entradas= para entregar 4 palabras: casa, sol, naranja y uva.
n = int(input())
palavras = []
for i in range(n):
    palavras.append(input())
for i in range(1, n):
    atual = palavras[i]
    j = i - 1
    while j >= 0 and len(palavras[j]) > len(atual):
        palavras[j + 1] = palavras[j]
        j -= 1
    palavras[j + 1] = atual
print(palavras)
print("más corta:", palavras[0], "más larga:", palavras[-1])
print("fin")El simulador repite en la salida los valores escritos, uno por línea, y después vienen ['sol', 'uva', 'casa', 'naranja'], más corta: sol más larga: naranja y fin.
El único cambio respecto del insertion sort de números es que la comparación usa len(palavras[j]) > len(atual), el tamaño de las palabras, en lugar de las palabras mismas. Como la comparación es estricta, sol y uva, que tienen 3 letras, quedan en el orden en que fueron escritas: sol antes de uva. Esta es la estabilidad en acción.
Para practicar, prueba: ordenar de mayor a menor, cambiando solo la comparación; ordenar en orden alfabético sin usar el len; cambiar el insertion por el sorted(palavras, key=len) y ver, en el simulador, si los empates salen en el mismo orden; y contar cuántos desplazamientos se hicieron.
Preguntas frecuentes
¿Por qué el insertion sort es mejor en listas casi ordenadas? Porque cada elemento avanza solo hasta encontrar su lugar. En una lista casi ordenada, la mayoría ya está en su lugar y no avanza nada. El trabajo es proporcional al desorden, como mostraron las 102 comparaciones para 100 elementos.
¿El insertion sort es estable? Con la comparación > estricta, sí: los elementos iguales no se pasan uno al otro. Si la comparación fuera >=, los iguales se desplazarían en vano, y el orden de entrada dejaría de conservarse.
¿Por qué el sorted() del simulador puede invertir los empates? Porque el simulador reproduce el algoritmo de ordenación de MicroPython, que no es estable, como explica el artículo sobre sorted con key. El Python de computador usa otro y es estable.
¿Debo usar sorted() o sort()? El sorted() devuelve una lista nueva y mantiene la original. El sort() ordena la propia lista y devuelve None. Elige según necesites guardar o no el orden original.
¿El insert es caro? Empuja todos los elementos siguientes una casilla a la derecha, lo que cuesta más cuanto mayor es la lista. Para las listas pequeñas de una placa, es perfectamente aceptable.
¿Existe algo más rápido que estos tres algoritmos? Existe. El próximo artículo presenta el merge sort y el quick sort, que dividen la lista en partes menores y ordenan mucho más rápido listas grandes.
Para continuar
Los desafíos Búsqueda en la lista, Mayor de la lista y Lista al revés practican el recorrido y el desplazamiento de elementos que usa el insertion sort. Para repasar la base, vale la pena pasar por los artículos sobre listas, búsqueda lineal y binaria, bubble y selection sort y lambda, map, filter y sorted, y por la ruta de lógica.
El próximo artículo trata del merge sort y el quick sort: qué significa dividir para conquistar, cómo entra la recursión en la ordenación y por qué estos algoritmos son más rápidos en listas grandes.