Fundamentos
Diccionarios en Python: clave, valor y conteos
Aprende diccionarios en Python: crear, leer con [] y get, modificar, recorrer con items, contar palabras, agrupar y el orden de los elementos en MicroPython.
Por Prof. Rodrigo Faustino · Actualizado el · 16 min de lectura
Métricas de este artículo
- Palabras
- 3191
- Caracteres
- 18.103
- Tiempo de lectura
- ~16 min
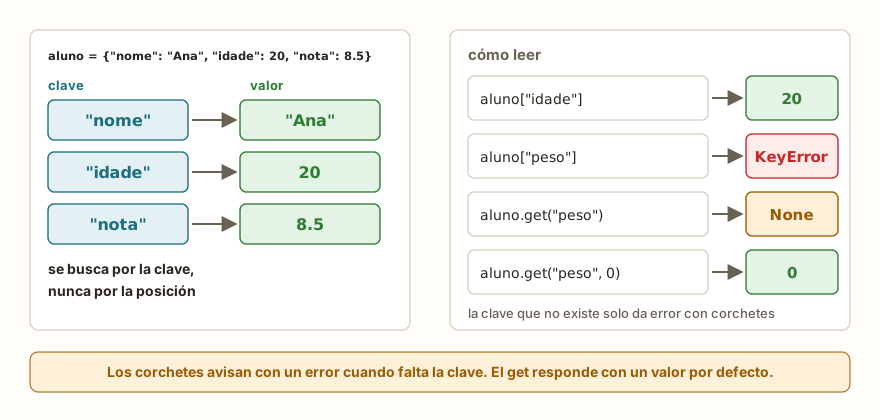
Un diccionario guarda valores que se encuentran por una clave, y no por una posición. En lugar de preguntar "¿qué hay en el índice 2?", el programa pregunta "¿cuál es la edad?", y el diccionario responde. Se escribe entre llaves, con pares clave: valor separados por comas, como en {"nome": "Ana", "idade": 20}. Es la estructura adecuada para registros, tablas de consulta, configuraciones y, sobre todo, conteos.
En los artículos anteriores, la posición decía qué era cada elemento: el primero, el último, el del índice 3. Eso funciona bien para una secuencia de valores del mismo tipo y del mismo significado, como notas o lecturas de sensor. Cuando cada valor tiene un papel propio, o cuando la pregunta es "¿cuántas veces apareció?", la clave es más clara que el número de la posición. Este artículo muestra cómo crear, leer, modificar y recorrer diccionarios, cómo contar y agrupar, una diferencia importante en el orden de los elementos entre el simulador y el Python de computador, los errores más comunes y usos en la ESP32.
Crear un diccionario
vazio = {}
aluno = {"nome": "Ana", "idade": 20, "nota": 8.5}
print(vazio, aluno)
print(type(vazio), len(aluno))
print(aluno["nome"], aluno["idade"])
print(dict(a=1, b=2))
print(dict([("x", 1), ("y", 2)]))
print(dict(zip(["a", "b", "c"], [1, 2, 3])))
print(aluno.get("nome"))
print(aluno.get("peso"))
print(aluno.get("peso", 0))
print("nome" in aluno, "peso" in aluno, "Ana" in aluno)
print("fin")La salida tiene {} y el diccionario aluno en la primera línea, después <class 'dict'> 3, Ana 20, y las tres formas de crear a partir de dict(...). Después vienen Ana, None, 0 y True False False, y por último fin. El orden en que aparecen las claves en las líneas que imprimen diccionarios merece una sección propia, más adelante.
El {} vacío crea un diccionario, y no un conjunto: el conjunto vacío tiene otro nombre, que el artículo sobre conjuntos muestra. La función dict(...) arma un diccionario de otras formas: con nombres (dict(a=1, b=2)), con una lista de pares en tuplas, como las del artículo anterior, o juntando dos listas con zip, una de claves y otra de valores. El len cuenta los pares.
Del programa al semestre planificado
- Plan de enseñanza y calendario montados solos
- Diario de clases listo para pegar en el SIGA
- Diapositivas y listas de ejercicios con solucionario
Versión Community gratis · Windows
Leer un valor: [] y get
Hay dos maneras de leer, y la diferencia entre ellas es lo que ocurre cuando la clave no existe. Con corchetes, aluno["idade"] devuelve el valor, y una clave ausente da KeyError. Con el método get, aluno.get("peso") devuelve None si la clave falta, y aluno.get("peso", 0) devuelve el valor por defecto que tú elijas, en este caso el 0.
La pregunta "nome" in aluno prueba las claves. La última comparación del ejemplo, "Ana" in aluno, dio False, porque "Ana" es un valor, y no una clave. Para preguntar por valores, el camino es "Ana" in aluno.values().
La elección entre las dos lecturas es de intención. Si la clave tiene que existir, y la ausencia es un error, los corchetes avisan en voz alta con el error. Si la ausencia es normal, como al contar apariciones, el get evita el if.
Modificar: agregar, cambiar y quitar
Asignar a una clave nueva agrega el par, y asignar a una clave que ya existe cambia el valor. No hay append, porque no hay "final" ni posición.
d = {"a": 1}
d["b"] = 2
d["a"] = 10
print(d)
d["c"] = 3
x = d.pop("c")
print(x, d)
print(d.pop("zzz", "no tenía"))
del d["b"]
print(d)
d.update({"p": 5, "q": 6})
print(d)
d.update(a=99)
print(d)
print(d.setdefault("novo", 0))
print(d.setdefault("p", 100))
print(d)
d.clear()
print(d, len(d))
print("fin")La salida es {'a': 10, 'b': 2}, después 3 {'a': 10, 'b': 2}, no tenía, {'a': 10}, y las líneas del update, que son {'a': 10, 'q': 6, 'p': 5} y {'a': 99, 'q': 6, 'p': 5}. A continuación aparecen 0, 5, {'a': 99, 'q': 6, 'p': 5, 'novo': 0}, {} 0 y fin.
El pop(clave) quita el par y devuelve el valor, y con un segundo argumento (pop("zzz", "no tenía")) devuelve ese valor por defecto en lugar de dar error. El del d["b"] quita sin devolver nada. El update junta los pares de otro diccionario o de argumentos con nombre, cambiando los que ya existían. El setdefault(clave, valor por defecto) hace dos cosas: devuelve el valor de la clave si existe, y si no existe, la crea con el valor por defecto y lo devuelve. Esto será útil para agrupar, más adelante. El clear vacía.
El orden de los elementos no es el de inserción
Mira de nuevo las salidas anteriores. El diccionario del update se armó como a, después p, después q, y se imprimió como a, q, p. Esto no es un defecto del simulador.
En el Python de computador, a partir de la versión 3.7, un diccionario recuerda el orden en que se insertaron los pares, y imprime en ese orden. En MicroPython, que corre en la ESP32, el diccionario es una tabla de dispersión (hash) y los elementos aparecen en el orden en que la tabla los guarda, que depende de las claves y no del orden de escritura. El simulador copia ese comportamiento, y por eso los órdenes que aparecen en los print y en los bucles de este artículo son los de MicroPython y pueden ser distintos de los que muestra tu Python de computador.
La consecuencia práctica es una regla simple: nunca dependas del orden de las claves de un diccionario. Si el programa necesita un orden, lo pide. El sorted(d) devuelve las claves en orden alfabético, y el sorted(d.items(), key=...) ordena los pares por donde tú mandes. Para leer un valor, el orden no importa, porque la lectura es por la clave.
La IA que recuerda tu vida y vive en tu ordenador
- Memoria a largo plazo con la fuente de cada respuesta
- Funciona sin conexión: tus datos se quedan en tu PC
- Lee PDF, diapositivas, fotos y grabaciones de reuniones
Plan Esencial gratis para siempre
Recorrer un diccionario
d = {"verde": 18, "amarelo": 19, "vermelho": 21}
for chave in d:
    print(chave)
print(list(d.keys()))
print(list(d.values()))
print(list(d.items()))
for nome, pino in d.items():
    print(nome, "->", pino)
print(sorted(d))
print(sorted(d.items(), key=lambda p: p[1], reverse=True))
print(sum(d.values()), max(d.values()), min(d, key=d.get))
print("fin")La salida empieza con las claves verde, vermelho y amarelo, una por línea, en el orden de la tabla de MicroPython. A continuación vienen ['verde', 'vermelho', 'amarelo'], [18, 21, 19] y [('verde', 18), ('vermelho', 21), ('amarelo', 19)], y después verde -> 18, vermelho -> 21 y amarelo -> 19. Las últimas líneas son ['amarelo', 'verde', 'vermelho'], [('vermelho', 21), ('amarelo', 19), ('verde', 18)], 58 21 verde y fin.
Un for directo sobre el diccionario entrega las claves. El keys() entrega solo las claves, el values() solo los valores, y el items() entrega los pares, cada uno como una tupla. Por eso funciona el for nome, pino in d.items(): la tupla (nome, pino) se desempaqueta en cada vuelta, como en el for x, y in pontos del artículo sobre tuplas. Esa es la forma más común de recorrer un diccionario.
Las tres últimas líneas muestran a los compañeros de siempre. El sorted(d) ordena las claves, y sorted(d.items(), key=lambda p: p[1], reverse=True) ordena los pares por el valor, del mayor al menor, como en el artículo sobre lambda, map, filter y sorted. El sum y el max aceptan los valores, y el min(d, key=d.get) devuelve la clave del menor valor: el d.get sirve de criterio, y el resultado es verde, cuyo pin 18 es el menor.
Una observación: el keys(), el values() y el items() entregan vistas, y no listas. Para tener una lista, envuélvelas con list(...), como en el ejemplo. No se puede indexar una vista, lo que se ve en los errores más adelante.
Contar: el uso más valioso
Contar cuántas veces aparece cada cosa es el trabajo en que el diccionario brilla. La idea es una clave por cosa y, como valor, la cuenta:
texto = "el gato y el ratón y el gato"
contagem = {}
for palavra in texto.split():
    contagem[palavra] = contagem.get(palavra, 0) + 1
print(contagem)
for palavra, n in sorted(contagem.items(), key=lambda p: (-p[1], p[0])):
    print(palavra, n)
letras = {}
for c in "banana":
    letras[c] = letras.get(c, 0) + 1
print(letras)
print("fin")La salida es {'el': 3, 'gato': 2, 'y': 2, 'ratón': 1}, después las líneas el 3, gato 2, y 2 y ratón 1, después {'a': 3, 'n': 2, 'b': 1} y fin.

La línea contagem[palavra] = contagem.get(palavra, 0) + 1 es un patrón para memorizar. El get(palavra, 0) devuelve la cuenta actual, o 0 si la palabra todavía no apareció, y el + 1 suma la aparición de ahora. El resultado se guarda en la misma clave. La figura muestra el diccionario creciendo palabra por palabra.
El texto.split() separa el texto en palabras y devuelve una lista, lo que se verá en detalle en el artículo sobre strings. El "banana" del segundo caso muestra que el for sobre un texto entrega letra por letra, y que el mismo molde cuenta letras.
La ordenación final merece una mirada. La clave (-p[1], p[0]) es una tupla: primero el negativo de la cuenta, para que el mayor quede al frente, y después la palabra, para desempatar en orden alfabético. Es la clave compuesta del artículo sobre sorted, y garantiza una salida predecible cuando dos palabras empatan, como gato e y, ambas con 2. Sin el desempate, el orden de los empatados dependería de la tabla del diccionario.
El error clásico de esta cuenta es escribir solo contagem[palavra] += 1, sin el get. La primera vez que una palabra aparece, la clave no existe y el resultado es KeyError. Las dos salidas son el get con valor por defecto, como arriba, o la prueba if palavra in contagem.
Agrupar: un diccionario de listas
Otro uso es guardar, para cada clave, una lista de elementos. Es el caso de agrupar alumnos por grupo, lecturas por sensor o eventos por tipo:
alunos = [("Ana", "A"), ("Bia", "B"), ("Caio", "A"), ("Duda", "B"), ("Edu", "A")]
turmas = {}
for nome, turma in alunos:
    turmas.setdefault(turma, []).append(nome)
print(turmas)
turmas2 = {}
for nome, turma in alunos:
    if turma not in turmas2:
        turmas2[turma] = []
    turmas2[turma].append(nome)
print(turmas2 == turmas)
print("fin")La salida es {'A': ['Ana', 'Caio', 'Edu'], 'B': ['Bia', 'Duda']}, True y fin. El for nome, turma in alunos desempaqueta cada tupla. El turmas.setdefault(turma, []) devuelve la lista del grupo, creando una lista vacía cuando el grupo es nuevo, y el .append(nome) agrega a la lista devuelta. La segunda forma hace lo mismo con un if, y la comparación turmas2 == turmas muestra que el resultado es igual. La forma con setdefault es más corta, y la del if es más fácil de leer cuando se está empezando.
Copia y comprensión de diccionario
El diccionario es mutable, como la lista, y la asignación b = a también solo crea otro nombre para el mismo diccionario:
a = {"x": 1}
b = a
b["y"] = 2
print(a, b, a is b)
c = a.copy()
c["z"] = 3
print(a, c, a is c)
print({n: n * n for n in range(4)})
d = {"a": 1, "b": 2}
print({v: k for k, v in d.items()})
print({k: v for k, v in d.items() if v > 1})
print({(0, 0): "origen", (3, 4): "punto"}[(3, 4)])
duplicada = {"a": 1, "a": 2}
print(duplicada)
print("fin")La salida es {'y': 2, 'x': 1} {'y': 2, 'x': 1} True, después {'y': 2, 'x': 1} {'y': 2, 'x': 1, 'z': 3} False, {0: 0, 1: 1, 2: 4, 3: 9}, {2: 'b', 1: 'a'}, {'b': 2}, punto, {'a': 2} y fin.
Las dos primeras líneas repiten la lección del artículo sobre listas: después de b = a, tocar b cambia a, y el is confirma que solo hay un diccionario. El copy() crea otro, y los dos pasan a cambiar de forma independiente. La copia es superficial: los valores que son listas siguen compartidos entre las dos copias.
Las tres líneas siguientes son comprensiones de diccionario, la versión con llaves de las comprensiones de lista del artículo sobre operaciones con listas. La forma es {clave: valor for ... in ...}, con if opcional al final. La primera crea una tabla de cuadrados, la segunda invierte un diccionario, intercambiando claves por valores, y la tercera filtra solo los pares cuyo valor pasa la prueba. Invertir solo funciona cuando los valores son todos distintos: si dos valores son iguales, gana el último, y un par desaparece.
El penúltimo ejemplo muestra que una tupla sirve de clave. La tupla (3, 4) lleva al texto punto, como anticipó el artículo anterior, y así se guarda algo indexado por coordenada. La lista, por ser mutable, no sirve de clave, y el error está en la sección de errores.
El último caso muestra una clave repetida: {"a": 1, "a": 2} no da error, y queda el último valor. Esto explica una sorpresa común: si el diccionario parece tener menos elementos de los que escribiste, busca una clave duplicada.
Lista de diccionarios: registros

Cuando cada elemento de una colección tiene varios campos, el formato más natural es una lista en que cada elemento es un diccionario. Cada diccionario es un registro, y el conjunto entero es una pequeña tabla:
alunos = [
    {"nome": "Ana", "nota": 8},
    {"nome": "Bia", "nota": 5},
    {"nome": "Caio", "nota": 9},
]
for a in alunos:
    print(a["nome"], a["nota"])
aprovados = [a["nome"] for a in alunos if a["nota"] >= 6]
print(aprovados)
media = sum(a["nota"] for a in alunos) // len(alunos)
print(media)
melhor = max(alunos, key=lambda a: a["nota"])
print(melhor)
alunos[1]["nota"] = 7
print(alunos[1])
print("fin")La salida es Ana 8, Bia 5, Caio 9, ['Ana', 'Caio'], 7, {'nome': 'Caio', 'nota': 9}, {'nome': 'Bia', 'nota': 7} y fin. El for a in alunos entrega un diccionario por vuelta, y a["nome"] lee el campo. El filtro y el max con key siguen los moldes del artículo anterior, solo que ahora la cuenta se hace con a["nota"]. Para cambiar un campo, primero el índice de la lista y después la clave: alunos[1]["nota"] = 7.
Este formato, lista de diccionarios, tiene el mismo aspecto que los datos en JSON, que aparece más abajo.
En la ESP32: tablas de consulta, configuración y lecturas
Un diccionario se vuelve una tabla de consulta cuando hace el papel de una cadena de if y elif. En lugar de probar cada nombre de color y elegir el pin, el programa guarda el pin en un diccionario y lo lee por la clave:
from machine import Pin
from time import sleep

LEDS = {
    "verde": Pin(18, Pin.OUT),
    "amarillo": Pin(19, Pin.OUT),
    "rojo": Pin(21, Pin.OUT),
}
sequencia = ["verde", "amarillo", "rojo", "amarillo"]
for cor in sequencia:
    LEDS[cor].on()
    sleep(0.1)
    LEDS[cor].off()
print(len(LEDS), list(LEDS))

CONFIG = {"intervalo": 5, "limite": 30, "modo": "auto"}
leitura = {"temp": 24, "umid": 61}
if leitura["temp"] < CONFIG["limite"]:
    print("temperatura normal")
leitura["alerta"] = leitura["temp"] >= CONFIG["limite"]
print(leitura)
print("fin")La salida es 3 ['verde', 'amarillo', 'rojo'], temperatura normal, {'umid': 61, 'temp': 24, 'alerta': False} y fin. El diccionario LEDS guarda objetos Pin como valores, y la secuencia de colores, que puede tener el orden y las repeticiones que quieras, se recorre por el nombre de cada LED. Cambiar el orden del semáforo pasa a ser editar la lista sequencia, y no el código del bucle. El diccionario CONFIG junta las configuraciones en un solo lugar, con nombres que se explican solos, y la leitura es un registro que gana un campo alerta calculado a partir de otros dos.
Observa que list(LEDS) y leitura aparecen con los elementos fuera del orden de escritura, lo que repite el aviso de la sección sobre el orden.
Un diccionario también se vuelve texto para viajar por la red. El módulo json convierte en los dos sentidos:
import json
leitura = {"temp": 24, "umid": 61}
texto = json.dumps(leitura)
print(texto, type(texto))
volta = json.loads(texto)
print(volta, volta["temp"])
print("fin")La salida es {"umid": 61, "temp": 24} <class 'str'>, {'umid': 61, 'temp': 24} 24 y fin. El json.dumps transforma el diccionario en un texto y el json.loads lo transforma de vuelta. Así es como suelen enviarse las lecturas por HTTP o por MQTT, como en el artículo sobre Wi-Fi, HTTP y MQTT en la ESP32. Fíjate en que el texto también sale en el orden de la tabla, que no es el de escritura, y quien lee del otro lado recibe los campos por los nombres, así que el orden no importa.
Errores comunes
Los mensajes de abajo son los del simulador, que imita a MicroPython. En algunos casos el texto es distinto del del Python de computador, y lo señalo cuando es así.
d = {"nome": "Ana"}
print(d["idade"])KeyError: idadeLa clave no existe. El simulador muestra el nombre sin comillas, y el Python de computador escribe KeyError: 'idade'. La cura es decidir si la ausencia es un error, y entonces mantener los corchetes, o si es normal, y entonces usar get o in.
d = {"a": 1}
d["b"] += 1KeyError: bEl += lee la clave antes de sumar, y la clave b no existe. Es el error más común en los conteos, y se resuelve con d["b"] = d.get("b", 0) + 1.
d = {"a": 1}
d.append(2)AttributeError: 'dict' object has no attribute 'append'El diccionario no tiene append, porque no tiene posición. Para agregar, asigna a una clave nueva.
d = {"a": 1}
print(d[0])KeyError: 0El índice de una lista no funciona en un diccionario. El 0 aquí se trata como una clave, y no como la posición. Quien espera "el primer elemento" necesita list(d)[0], recordando que el orden no es el de escritura.
d = {"a": 1}
print(d.get("x").upper())AttributeError: 'NoneType' object has no attribute 'upper'El get sin valor por defecto devolvió None, y se llamó al .upper() sobre él. Da un valor por defecto del tipo correcto, como d.get("x", ""), o prueba antes.
d = {"a": 1, "b": 2}
for k, v in d:
print(k, v)ValueError: need more than 1 values to unpackEl for sobre el diccionario entrega solo las claves, y el k, v intenta abrir cada clave en dos nombres. Aquí las claves tienen una sola letra, y el mensaje dice que falta un valor. Con claves más largas, el error sería otro, de exceso, porque el texto se abriría letra por letra. La corrección es siempre d.items().
d = {[1, 2]: "x"}TypeError: unsupported type for __hash__: 'list'Una lista no puede ser clave, porque puede cambiar. La tupla (1, 2) sí puede. El Python de computador dice unhashable type: 'list'.
d = {"a": 1}
print(d.keys()[0])TypeError: 'dict_view' object isn't subscriptableLa vista que entrega el keys() no acepta índice. Usa list(d.keys())[0].
Hay todavía un caso que en el Python de computador da RuntimeError: dictionary changed size during iteration: agregar claves a un diccionario mientras se recorre ese mismo diccionario. En el simulador, el bucle de prueba terminó sin error, y aun así el comportamiento no debe usarse, igual que borrar elementos de una lista dentro de un for. El camino seguro es recorrer una copia, como for k in list(d):, o armar un diccionario nuevo.
Lo que suele aparecer en el aula
Estos patrones se repiten en grupos de todos los niveles.
El primero es el KeyError en un conteo: el alumno escribe contagem[x] += 1, el programa funciona en la primera prueba porque la clave ya estaba allí, y se rompe en la segunda. La pregunta que lo resuelve es "¿y la primera vez que esa palabra aparece, qué tiene el diccionario?".
El segundo es el d[0] esperando "el primer elemento". Quien viene de las listas trae el hábito de preguntar por posición, y el diccionario responde con un KeyError: 0 que parece extraño.
El tercero es esperar el orden de escritura. En el computador casi siempre vale, y en la ESP32 no. Un programa que funciona en la máquina e imprime los campos en otro orden en la placa es un síntoma típico, y la cura es pedir el orden con sorted.
El cuarto es la confusión entre in con claves y con valores. La prueba "Ana" in aluno da False y el alumno jura que Ana está allí. Está, pero como valor.
El quinto es el for k, v in d sin el .items(), visto arriba.
El sexto es la clave repetida, que desaparece en silencio: el alumno escribe dos elementos con la misma clave, y el primero se pierde.
El séptimo es creer que b = a copia el diccionario, que es la misma trampa de las listas, y suele aparecer en quien acaba de aprender la diferencia para las listas y cree que el diccionario "es diferente".
Ejercicio: palabras más comunes
Escribe un programa que pregunte cuántas palabras se leerán, lea cada una, cuente cuántas veces aparece cada palabra y muestre la cantidad de palabras distintas, cada palabra con su cuenta, de la más frecuente a la menos, y cuál es la más común.
quantidade = int(input("cuántas palabras: "))
contagem = {}
for i in range(quantidade):
    palavra = input("palabra: ")
    contagem[palavra] = contagem.get(palavra, 0) + 1
print("distintas", len(contagem))
ordenadas = sorted(contagem.items(), key=lambda p: (-p[1], p[0]))
for palavra, n in ordenadas:
    print(palavra, n)
print("más común", ordenadas[0][0])Con las entradas 8, el, gato, y, el, ratón, y, el y gato, las líneas finales son distintas 4, el 3, gato 2, y 2, ratón 1 y más común el. El ordenadas[0][0] es el primer par de la lista, y dentro de él la palabra. Para practicar, muestra también las palabras que aparecen una sola vez, y haz que el programa ignore mayúsculas y minúsculas, aplicando .lower() a cada palabra antes de contar. Después, cambia la lectura palabra por palabra por una frase entera con input().split(), que el artículo sobre strings explica. ¿Qué pasa si el usuario escribe 0 como cantidad? Pruébalo y protege el programa.
Preguntas frecuentes
¿Cuándo uso diccionario y cuándo uso lista? Usa lista cuando la posición o el orden es lo que importa, y los elementos son del mismo tipo. Usa diccionario cuando cada valor tiene un nombre, o cuando necesitas encontrar algo por el nombre rápidamente.
¿La clave puede ser un número? Puede. Los números, los textos y las tuplas sirven. Las listas y otros diccionarios, no, porque pueden cambiar.
¿El diccionario es más rápido que la lista para buscar? Buscar una clave en un diccionario no recorre los elementos uno a uno, y por eso es la estructura para consultas. Este artículo no midió tiempos en la ESP32.
¿Cuál es la diferencia entre d["x"] y d.get("x")? Los corchetes dan KeyError cuando la clave no existe, y el get devuelve None o el valor por defecto que pidas.
¿Cómo junto dos diccionarios? Con update, que modifica el primero, y que cambia los valores de las claves repetidas. La suma d1 + d2 no existe y da TypeError.
Para continuar
El desafío Búsqueda en la lista trabaja la idea de buscar un valor, que el diccionario resuelve por clave. Para repasar las bases, los artículos sobre listas, operaciones con listas y tuplas completan este.
El próximo artículo trata de los conjuntos: colecciones sin repetición, que responden en una línea a preguntas como "qué elementos están en las dos listas" y "cuáles aparecen en una sola".