IA
IA com ESP32: TinyML na placa e integração com um LLM
Os três jeitos de usar IA com a ESP32 — um modelo pequeno no chip, um LLM num servidor ou os dois juntos —, com exemplos e cuidados de segurança.
Por Prof. Rodrigo Faustino · Atualizado em · 12 min de leitura
Métricas deste artigo
- Palavras
- 2.271
- Caracteres
- 12.881
- Tempo de leitura
- ~12 min
"Dá para colocar inteligência artificial numa ESP32?" A resposta curta é sim, mas não do jeito que muita gente imagina. Um modelo de linguagem como os que conversam em chats não cabe numa placa de poucos dólares: os menores deles ocupam centenas de megabytes, e a ESP32 da DevKit V1 tem 4 MB de flash e, no MicroPython, menos de 200 KB de memória livre para o programa. O que cabe — e funciona muito bem — são modelos pequenos, treinados para uma pergunta só: "esta vibração é normal?", "este som é uma palma?", "esta leitura é de um ambiente abafado?".
Para perguntas abertas, em texto livre, o caminho é outro: a ESP32 conversa pela rede com um modelo grande, que roda num computador da escola, num servidor ou na nuvem. Este artigo mostra os dois caminhos e um terceiro, que junta os dois. Os exemplos com o botão Simular rodam no navegador; os de rede são para levar à placa de verdade.
Três caminhos

- IA na placa (o que se chama de TinyML, aprendizado de máquina minúsculo). Os dados são coletados com os sensores, o modelo é treinado no computador e depois implantado na ESP32, que passa a decidir sozinha. Funciona sem internet, responde em milissegundos e não manda os dados para lugar nenhum. Em troca, só responde à pergunta para a qual foi treinado.
- IA no servidor. A ESP32 lê os sensores e envia os dados para um servidor, que pergunta a um LLM (large language model, o modelo de linguagem grande) e devolve uma resposta. O LLM entende texto livre e sabe muitas coisas, mas precisa de rede, leva segundos para responder, pode custar dinheiro por pedido e pode errar com toda a confiança.
- Os dois juntos. O modelo pequeno, na placa, resolve os casos comuns na hora; só quando ele está inseguro a placa pergunta ao LLM. A maior parte das decisões não sai da placa, e a rede é usada pouco.
A IA que lembra da sua vida e mora no seu computador
- Memória de longo prazo com a fonte de cada resposta
- Funciona offline: seus dados ficam no seu PC
- Lê PDFs, slides, fotos e gravações de reunião
Plano Essencial grátis para sempre
IA na placa: coletar, treinar, implantar
Todo projeto de TinyML segue o mesmo ciclo de três passos.
Coletar. O modelo aprende com exemplos rotulados: leituras dos sensores acompanhadas da resposta certa. Para reconhecer um ambiente abafado, por exemplo, mede-se a temperatura e a umidade em vários dias e anota-se, em cada leitura, como o ambiente estava. Os dados podem ir para um arquivo CSV na própria placa, como no artigo guardar dados na ESP32, e depois para o computador. Esse é o passo mais trabalhoso e o que mais decide se o modelo vai funcionar: poucos exemplos, ou exemplos de um dia só, dão um modelo que acerta no laboratório e erra na vida real.
Treinar. No computador, um programa procura um jeito de ir das leituras ao rótulo. Para os modelos pequenos dos exemplos abaixo, "treinar" é só guardar os exemplos ou calcular médias. Para modelos maiores, usa-se uma biblioteca de aprendizado de máquina no computador, e o treino pode levar minutos.
Implantar. O modelo treinado vira um arquivo que vai para a placa — às vezes, uma simples lista de números dentro do main.py. Daí em diante, a ESP32 lê o sensor, passa a leitura pelo modelo e age com a resposta.
Primeiro modelo: os k vizinhos mais próximos
O modelo mais simples de entender é o k-vizinhos mais próximos (k-nearest neighbors, kNN). Ele guarda os exemplos rotulados e, para uma leitura nova, procura os k exemplos mais parecidos e responde com o rótulo que mais aparece entre eles. "Mais parecido" é a distância entre as leituras, a mesma régua da geometria.
O exemplo usa dez leituras de temperatura e umidade, como as de um DHT22, já rotuladas. Os números são exemplos inventados para a aula, não medidas: num projeto, eles vêm do passo de coleta.
import math

# (temperatura em °C, umidade em %, rótulo) — dados de exemplo para a aula
exemplos = [
    (18.0, 55, 'frio'),       (17.5, 60, 'frio'),      (19.0, 50, 'frio'),
    (23.0, 50, 'agradável'),  (24.5, 45, 'agradável'), (22.0, 55, 'agradável'),
    (29.0, 80, 'abafado'),    (31.0, 75, 'abafado'),   (28.0, 85, 'abafado'),
    (33.0, 40, 'quente seco'),
]

def distancia(a, b):
    # a umidade varia em dezenas e a temperatura em unidades: dividir pela faixa
    # deixa as duas com o mesmo peso (isso se chama normalizar)
    dt = (a[0] - b[0]) / 20
    du = (a[1] - b[1]) / 50
    return math.sqrt(dt * dt + du * du)

def classificar(leitura, k=3):
    perto = sorted(exemplos, key=lambda e: distancia(leitura, e))[:k]
    votos = {}
    for e in perto:
        votos[e[2]] = votos.get(e[2], 0) + 1
    rotulo = max(votos, key=votos.get)
    return rotulo, votos[rotulo], k

for leitura in [(30.0, 78), (21.0, 52), (18.5, 58), (26.0, 65)]:
    rotulo, a_favor, k = classificar(leitura)
print('%.1f °C, %d %% -> %s (%d de %d vizinhos)' % (leitura[0], leitura[1], rotulo, a_favor, k))Repare na leitura de 26 °C e 65 %: ela fica entre os grupos, e os vizinhos não concordam todos. A contagem de votos é uma medida de confiança que o modelo dá de graça — e é ela que permite o terceiro caminho, mais adiante.
O kNN tem um custo: a cada leitura, ele compara com todos os exemplos. Com dez, é instantâneo; com milhares, a placa passa a gastar tempo e memória. Por isso, nos projetos maiores, entram modelos que resumem os exemplos.
Treinar e implantar com o potenciômetro
Um modelo que resume os exemplos é o centroide mais próximo: treinar é calcular a média de cada grupo, e classificar é ver de qual média a leitura está mais perto. O modelo implantado são três números.
No circuito, o potenciômetro faz o papel de um sensor qualquer (uma alavanca, um sensor de luz, de umidade do solo). O programa já traz os exemplos "coletados" em três posições, treina, e depois lê o pino de verdade e classifica. Quando a leitura está longe de todos os centroides, o modelo diz que está inseguro — e, no terceiro caminho, esse é o momento de perguntar ao servidor.
from machine import ADC, Pin
import time

# 1. coletar: leituras em mV com o eixo em três posições (exemplos para a aula)
coletados = {
    'baixo': [210, 260, 190, 240, 230],
    'médio': [1580, 1660, 1700, 1620, 1640],
    'alto':  [2950, 3010, 2900, 3050, 2980],
}

# 2. treinar: o modelo é a média de cada grupo
modelo = {}
for rotulo, valores in coletados.items():
    modelo[rotulo] = sum(valores) / len(valores)
print('modelo treinado:', {r: round(m) for r, m in modelo.items()})

# 3. implantar: ler o sensor e escolher o centroide mais perto
LIMITE_INSEGURO = 400   # mV: mais longe que isso de todos, o modelo não confia
adc = ADC(Pin(34), atten=ADC.ATTN_11DB)

def prever(mv):
    rotulo = min(modelo, key=lambda r: abs(mv - modelo[r]))
    return rotulo, abs(mv - modelo[rotulo])

for i in range(3):
    mv = adc.read_uv() // 1000
    rotulo, dist = prever(mv)
    if dist > LIMITE_INSEGURO:
        print('%d mV -> inseguro (mais perto de %s, a %d mV): perguntaria ao servidor' % (mv, rotulo, dist))
    else:
        print('%d mV -> %s' % (mv, rotulo))
time.sleep(1)Gire o potenciômetro no simulador e rode de novo: perto das pontas, o modelo responde "baixo" ou "alto"; entre os grupos, ele se declara inseguro. O LIMITE_INSEGURO é uma escolha do projeto: maior, o modelo arrisca mais; menor, ele pergunta mais vezes.
Bibliotecas para modelos maiores
Quando o problema pede mais que médias e vizinhos — reconhecer um movimento num acelerômetro, um som, um gesto —, o trabalho pesado do treino fica no computador, com bibliotecas de aprendizado de máquina, e a placa recebe só o modelo pronto. Para MicroPython, um projeto aberto que faz isso é o emlearn-micropython. Segundo a página do projeto, ele oferece classificação com árvores de decisão e florestas aleatórias, kNN (inclusive aprendendo na própria placa), redes neurais convolucionais pequenas, regressão linear e agrupamento com k-médias, além de filtros e FFT para preparar os sinais. Os modelos rodam como módulos nativos (.mpy) que se instalam sem regravar o firmware; o projeto diz ser testado principalmente na arquitetura xtensawin, a da ESP32 e da ESP32-S3. Para a ESP32-C3, que é RISC-V, confira na documentação do projeto antes de planejar a aula.
A regra de ouro do TinyML vale para qualquer biblioteca: o modelo é tão bom quanto os dados com que foi treinado. Separe sempre uma parte dos exemplos para testar, sem usá-los no treino, e conte quantos o modelo acerta. Um modelo que acerta 100 % dos exemplos de treino e erra os de teste decorou a lista em vez de aprender.
IA no servidor: a ESP32 conversando com um LLM
O segundo caminho troca o modelo pequeno por um modelo de linguagem, que entende e escreve texto. A ESP32 entra como olhos e mãos: ela mede, envia, recebe uma resposta e age. A conversa é por HTTP, o mesmo requests do artigo Wi-Fi, HTTP e MQTT.
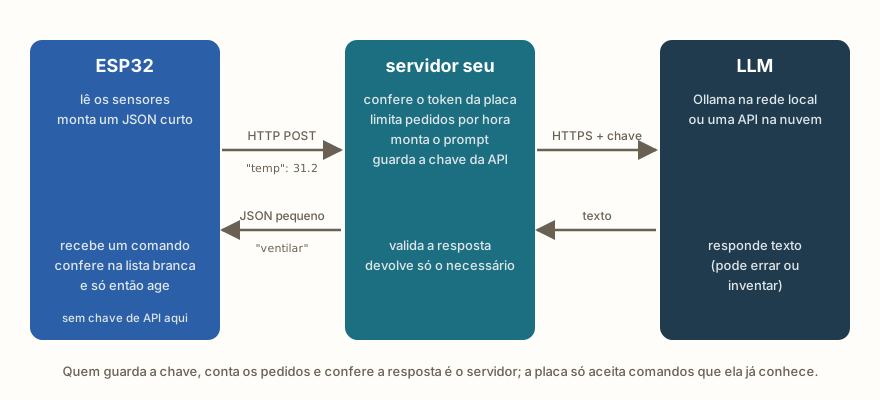
Há duas formas comuns de ter um LLM à disposição.
Um modelo na rede local, com o Ollama. O Ollama é um programa aberto que roda modelos de linguagem num computador comum. Ele atende pedidos HTTP na porta 11434; pela documentação, ele escuta só no próprio computador (127.0.0.1) até que a variável de ambiente OLLAMA_HOST mande escutar na rede, por exemplo com 0.0.0.0:11434. O pedido vai para /api/generate com o nome do modelo, o texto (prompt) e "stream": false, para receber a resposta inteira de uma vez no campo response. Os dados não saem da escola e não há chave nem custo por pedido; em troca, o computador precisa ficar ligado e ter memória para o modelo.
Uma API na nuvem. Empresas como a Anthropic, que faz o Claude, oferecem modelos por uma API paga, acessada com uma chave secreta. Os modelos são maiores e mais capazes, e o computador da escola não precisa fazer nada; em troca, cada pedido custa, os dados saem para a empresa e a chave precisa ser muito bem guardada.
Por que não chamar o LLM direto da placa
Parece natural colocar a chave da API no main.py e chamar a nuvem direto da ESP32. Não faça isso. A chave é como uma senha que gasta dinheiro: quem tiver acesso à placa — basta ligá-la num computador e listar os arquivos — copia a chave e passa a fazer pedidos na sua conta. A própria Anthropic recomenda, nas boas práticas de chaves, nunca colocá-las em código distribuído e guardá-las em variáveis de ambiente ou num cofre de segredos.
A arquitetura segura tem um servidor intermediário seu — um computador da escola, um serviço de hospedagem — entre a placa e o LLM, como na imagem. Ele:
- guarda a chave da API numa variável de ambiente, fora do código;
- reconhece a placa por um token próprio, que, se vazar, pode ser trocado sem mexer na conta da API;
- limita quantos pedidos cada placa faz por hora, para um laço com erro não esvaziar o saldo numa tarde;
- monta o prompt com as instruções e devolve à placa só um JSON curto, já conferido.
O servidor também alivia a placa: as respostas da API vêm em JSON grande e por HTTPS, e cada byte a menos é memória a mais para o programa da ESP32.
Pedir em JSON e conferir a resposta
Um LLM responde texto, e texto pode vir em qualquer formato — inclusive errado. A placa nunca deve executar o que o modelo escreveu como se fosse um comando confiável. O padrão que funciona tem três partes:
- o pedido diz ao modelo exatamente que formato devolver: um JSON com uma
acaodentre uma lista; - a resposta é lida com
json.loadsdentro de umtry, porque pode não ser JSON; - a
acaoé conferida numa lista branca de comandos que a placa conhece, e os valores são limitados a faixas seguras. O que não estiver na lista é ignorado.
O exemplo monta o pedido e testa a conferência com cinco respostas possíveis, entre elas uma inventada e uma que tenta pedir um pino que não existe no projeto. Ele roda inteiro no simulador, sem rede.
import json

ACOES = {'ventilar', 'aquecer', 'nada'}      # o que esta placa sabe fazer
PINOS_PERMITIDOS = {2, 4}                     # e onde

def montar_pedido(temp, umid):
    return json.dumps({
        'leitura': {'temperatura': temp, 'umidade': umid},
        'instrucao': 'Responda só um JSON {"acao": "ventilar"|"aquecer"|"nada", "pino": 2|4, "motivo": texto curto}',
    })

def conferir(texto):
    try:
        r = json.loads(texto)
    except ValueError:
        return None, 'resposta não é JSON'
    if not isinstance(r, dict):
        return None, 'resposta não é um objeto'
    acao = r.get('acao')
    if acao not in ACOES:
        return None, 'ação desconhecida: %r' % (acao,)
    pino = r.get('pino', 2)
    if pino not in PINOS_PERMITIDOS:
        return None, 'pino fora da lista: %r' % (pino,)
    return (acao, pino), str(r.get('motivo', ''))[:40]

print('pedido:', montar_pedido(31.2, 78))
print()

respostas = [
    '{"acao": "ventilar", "pino": 2, "motivo": "calor e umidade altos"}',
    '{"acao": "nada", "motivo": "ambiente ok"}',
    'Claro! Acho que você deveria ligar o ventilador.',
    '{"acao": "abrir_porta", "pino": 2}',
    '{"acao": "aquecer", "pino": 13}',
]
for texto in respostas:
    comando, info = conferir(texto)
    if comando and comando[0] == 'nada':
        print('aceita: nada a fazer (%s)' % info)
    elif comando:
        print('EXECUTA %s no GPIO%d (%s)' % (comando[0], comando[1], info))
    else:
print('ignora:', info)Só duas das cinco respostas são aceitas, e só uma liga algo. As outras três — texto solto, uma ação que a placa não tem, um pino fora da lista — são descartadas sem risco. Essa conferência é o que separa um projeto de demonstração de um projeto em que se pode confiar.
O código da placa
Com um Ollama na rede local, a ESP32 conversa direto com ele, sem chave. O campo format: "json" pede ao Ollama uma saída em JSON, e stream: False faz a resposta chegar de uma vez. O endereço e o nome do modelo são exemplos: use os do computador da escola.
import json
import requests

OLLAMA = 'http://192.168.0.50:11434/api/generate'   # computador com o Ollama

def perguntar(prompt):
    r = requests.post(OLLAMA, json={
        'model': 'nome-do-modelo',
        'prompt': prompt,
        'format': 'json',
        'stream': False,
    }, timeout=30)
    try:
        if r.status_code != 200:
            return None
        return r.json()['response']   # o texto do modelo, para passar por conferir()
    finally:
r.close()Com o servidor intermediário, a placa envia só as leituras e o token dela; quem fala com o LLM é o servidor.
import requests

SERVIDOR = 'https://meu-servidor.exemplo/api/decidir'
TOKEN_DA_PLACA = 'token-desta-placa'    # não é a chave da API: é um token só do seu servidor

r = requests.post(SERVIDOR, json={'temperatura': 31.2, 'umidade': 78},
                  headers={'Authorization': 'Bearer ' + TOKEN_DA_PLACA}, timeout=20)
try:
    if r.status_code == 200:
        comando = r.json()     # já conferido pelo servidor; a placa confere de novo
finally:
r.close()Do lado do servidor, um exemplo em Node.js com o SDK oficial da Anthropic (@anthropic-ai/sdk). A chave vem da variável de ambiente ANTHROPIC_API_KEY; o modelo claude-haiku-5-5 é da linha Haiku, a dos modelos menores e mais econômicos, e basta para respostas curtas como esta.
import http from 'node:http';
import Anthropic from '@anthropic-ai/sdk';

const cliente = new Anthropic();            // lê ANTHROPIC_API_KEY do ambiente
const TOKENS = new Set([process.env.TOKEN_PLACA_1]);
const ACOES = new Set(['ventilar', 'aquecer', 'nada']);

http.createServer(async (req, res) => {
  const token = (req.headers.authorization ?? '').replace('Bearer ', '');
  if (req.method !== 'POST' || !TOKENS.has(token)) { res.writeHead(401).end(); return; }
  let corpo = '';
  for await (const parte of req) corpo += parte;
  const { temperatura, umidade } = JSON.parse(corpo);

  const msg = await cliente.messages.create({
    model: 'claude-haiku-5-5',
    max_tokens: 100,
    system: 'Você controla uma sala de aula. Responda só um JSON {"acao": "ventilar"|"aquecer"|"nada", "pino": 2|4, "motivo": texto curto}.',
    messages: [{ role: 'user', content: `Temperatura ${Number(temperatura)} °C, umidade ${Number(umidade)} %.` }],
  });
  const texto = msg.content.filter((b) => b.type === 'text').map((b) => b.text).join('');

  let resposta = { acao: 'nada', pino: 2, motivo: 'resposta inválida' };
  try {
    const r = JSON.parse(texto);
    if (ACOES.has(r.acao) && [2, 4].includes(r.pino)) resposta = r;
  } catch { /* fica a resposta segura */ }
  res.writeHead(200, { 'Content-Type': 'application/json' }).end(JSON.stringify(resposta));
}).listen(process.env.PORT ?? 3000);Para um projeto de verdade, faltariam o limite de pedidos por hora e o HTTPS, mas o essencial está aí: a chave só no servidor, o token da placa conferido, o pedido montado pelo servidor e a resposta conferida duas vezes, no servidor e na placa.
Os dois juntos
O terceiro caminho junta o exemplo do potenciômetro com o do LLM: a placa usa o modelo pequeno e só faz o pedido de rede quando a leitura cai no "inseguro". Num sensor que mede a cada minuto, isso pode significar uma pergunta ao servidor por dia em vez de 1440 — menos custo, menos espera e muito menos bateria. O artigo baterias na ESP32 mostra quanto o rádio pesa na conta: cada pedido HTTP mantém o Wi-Fi ligado por segundos.
Da ementa ao semestre planejado
- Plano de ensino e calendário montados sozinhos
- Diário de aulas pronto para colar no SIGA
- Slides e listas de exercícios com gabarito
Versão Community grátis · Windows
Cuidados que valem para os três caminhos
- O modelo erra. Um modelo pequeno erra quando a situação é diferente dos dados de treino; um LLM erra com frases convincentes. Nada que possa machucar alguém ou estragar algo — um motor, um aquecedor, uma tranca — deve depender só da resposta de um modelo. Limites físicos (um fim de curso, um termostato) e limites no programa ficam sempre.
- Texto que vem de fora é dado, não ordem. Se a placa mandar ao LLM um texto que veio de outra pessoa (uma mensagem, um nome digitado), esse texto pode conter instruções para o modelo. A lista branca na placa é a última barreira.
- Privacidade. Leituras de uma sala, sons e imagens dizem muito sobre quem está lá. Prefira processar na placa ou na rede local, e só envie à nuvem o que for necessário.
- Rede falha. Use
timeoutem todo pedido e tenha sempre uma decisão padrão segura para quando o servidor não responder.
Para continuar
A trilha Analógico ensina a ler o potenciômetro e a lição média móvel mostra como limpar uma leitura antes de passá-la ao modelo. A trilha Sensores traz o DHT22, que fornece os dados do exemplo do kNN, e a trilha Wi-Fi e HTTP cobre o lado da rede. Para guardar os exemplos coletados, veja o artigo guardar dados na ESP32; para servir uma página com o resultado do modelo, o artigo servidor web na ESP32. As fichas da ESP32 DevKit V1, do potenciômetro e do DHT22 completam a montagem.
Fontes
- emlearn-micropython: modelos disponíveis, módulos nativos
.mpye arquiteturas testadas. - Documentação do Ollama: perguntas frequentes: porta 11434, endereço padrão e
OLLAMA_HOST. - Documentação do Ollama: /api/generate: campos
model,prompt,format,streameresponse. - SDK em TypeScript/JavaScript da Anthropic:
messages.createe a chave emANTHROPIC_API_KEY. - Boas práticas para chaves de API (Anthropic): não colocar chaves no código e guardá-las em variáveis de ambiente.
- Documentação do MicroPython: requests: o módulo HTTP da ESP32.
Para praticar no PyPlaca
Trilhas
- Trilha 4: Analógico: ADC, potenciômetro e LDR
- Trilha 5: Sensores: temperatura, distância e presença
- Trilha 8: Wi-Fi e HTTP